 ラピットくん
Jev は、文章を書いてくれません
TypeSafe AI の Playground を開くと、いきなりホットドッグの絵が出てきます。
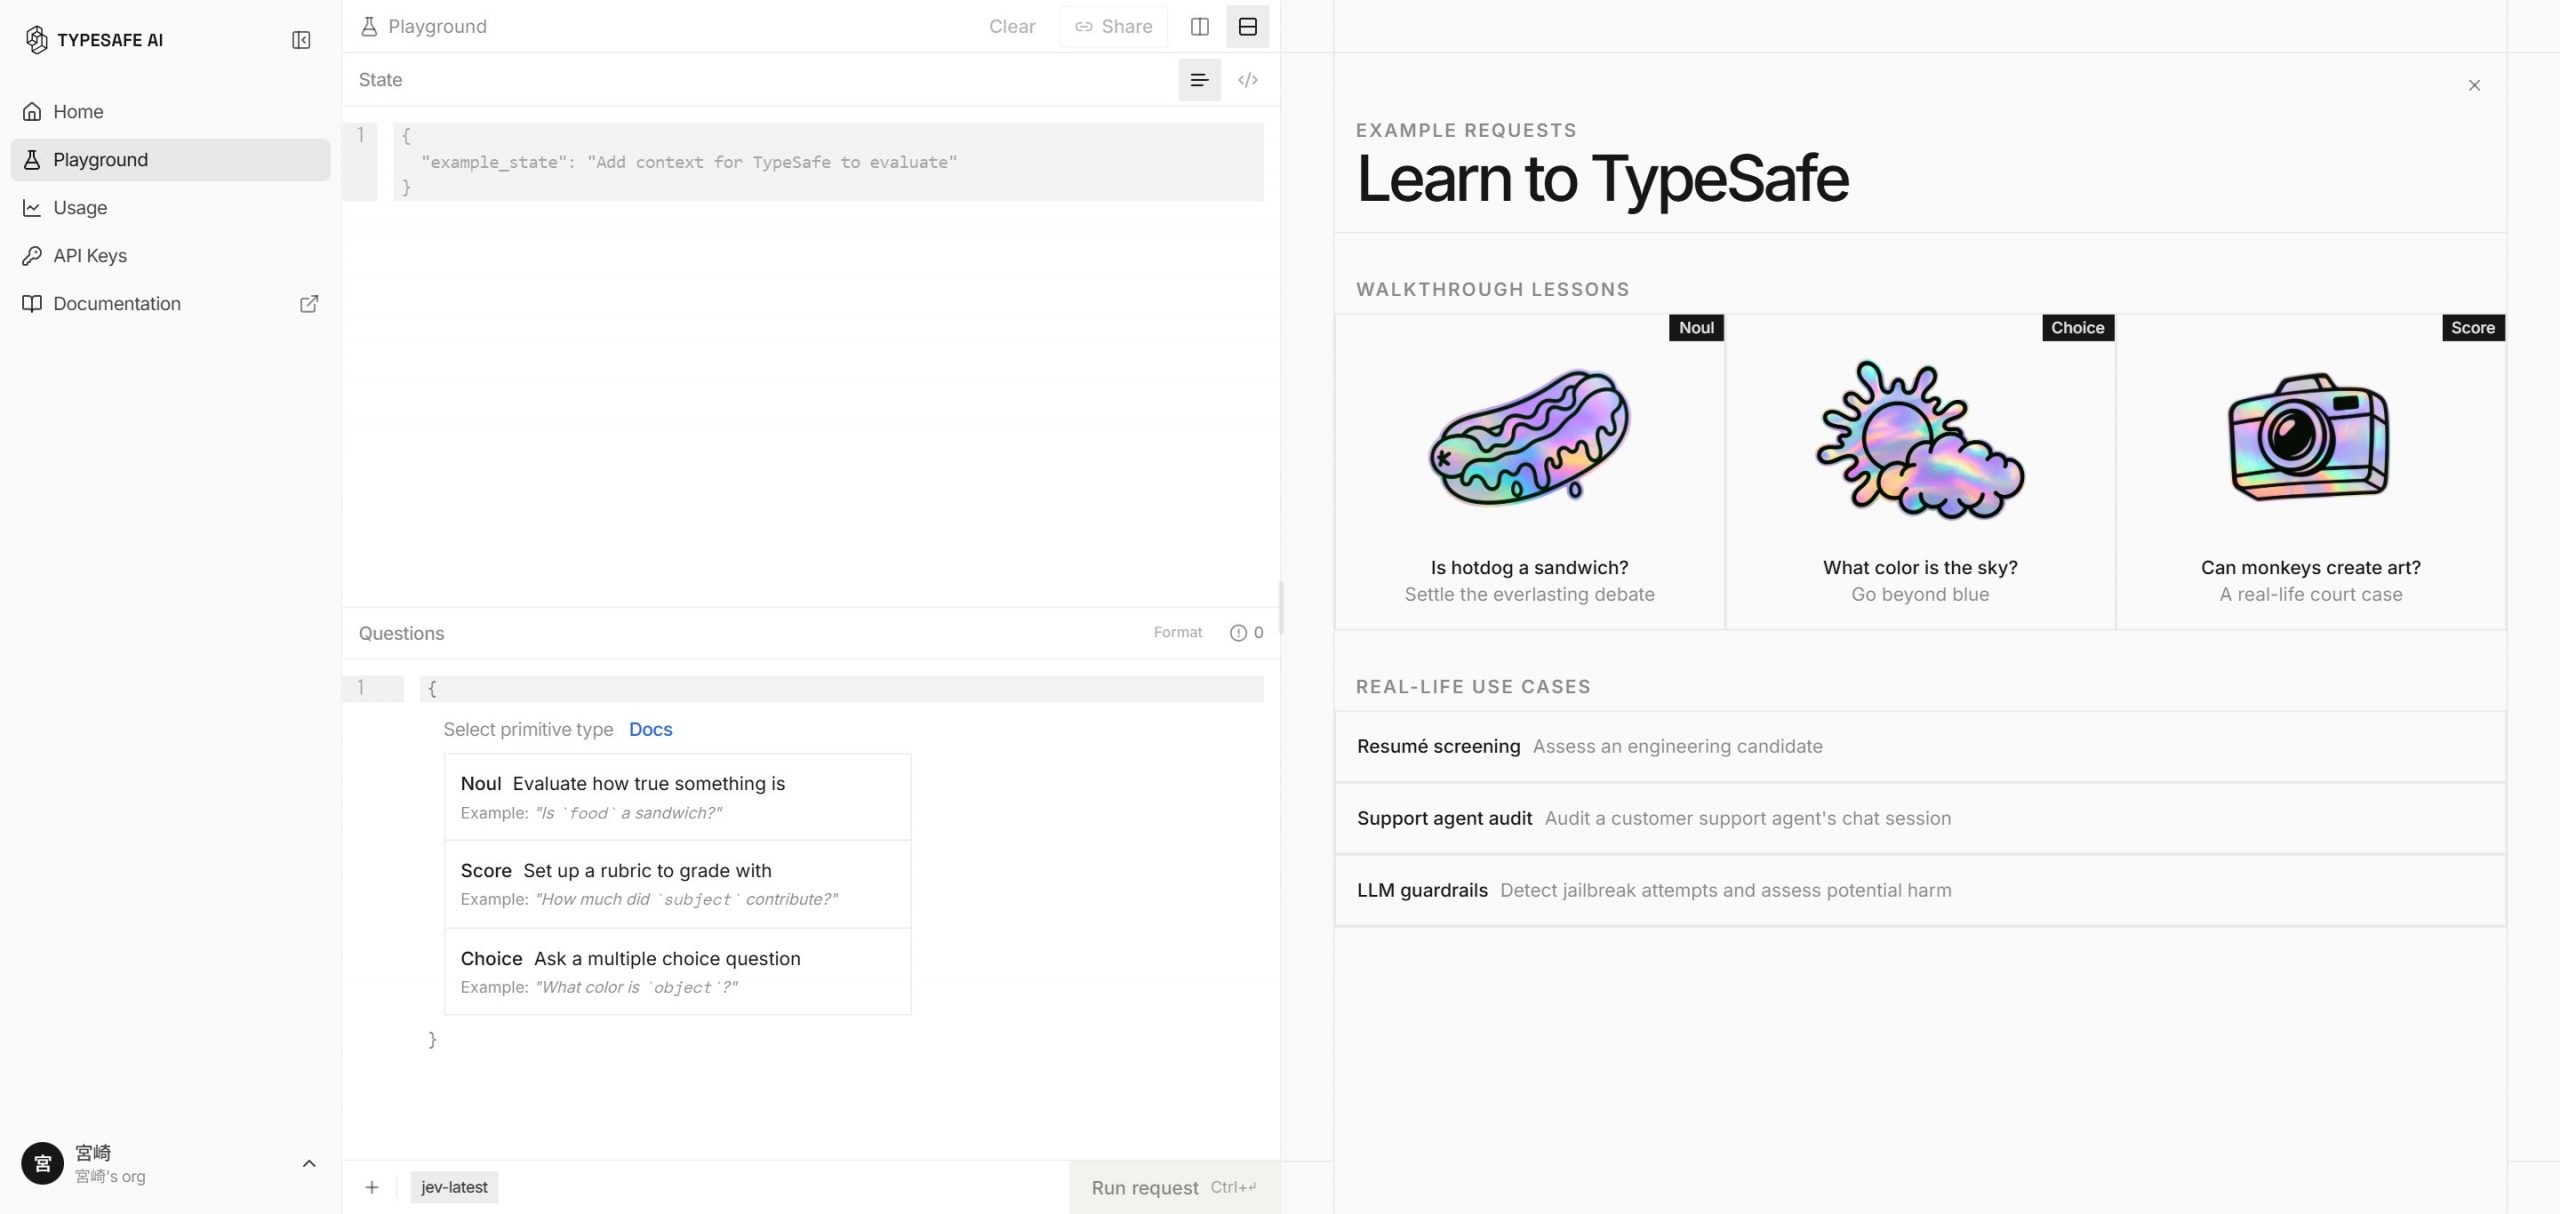
「ホットドッグはサンドイッチか?」
これが最初のレッスンです。ふざけているようで、実はこの問いに Jev の考え方が全部入っていました。
先に、いちばん大事なことを書いておきます。
Jev は、文章を書きません。
ChatGPT や Claude に何か聞くと、文章で返ってきます。「ホットドッグは、定義によってはサンドイッチとも言えますが……」みたいに。人が読むにはそれでいい。
でも、プログラムに判断させたいときは困ります。「言えますが」は、if 文に入らないので。
TypeSafe のドキュメントにも、ほぼそのまま書いてあります。文章を作るためのモデルに判断をさせて、その文章をまた読み解いてコードに戻す。そこにずれがある、と。
なので Jev は、答えの形を先に決めて聞くAIです。返ってくるのは文章ではなく、数字と選択肢。プログラムがそのまま使える形です。
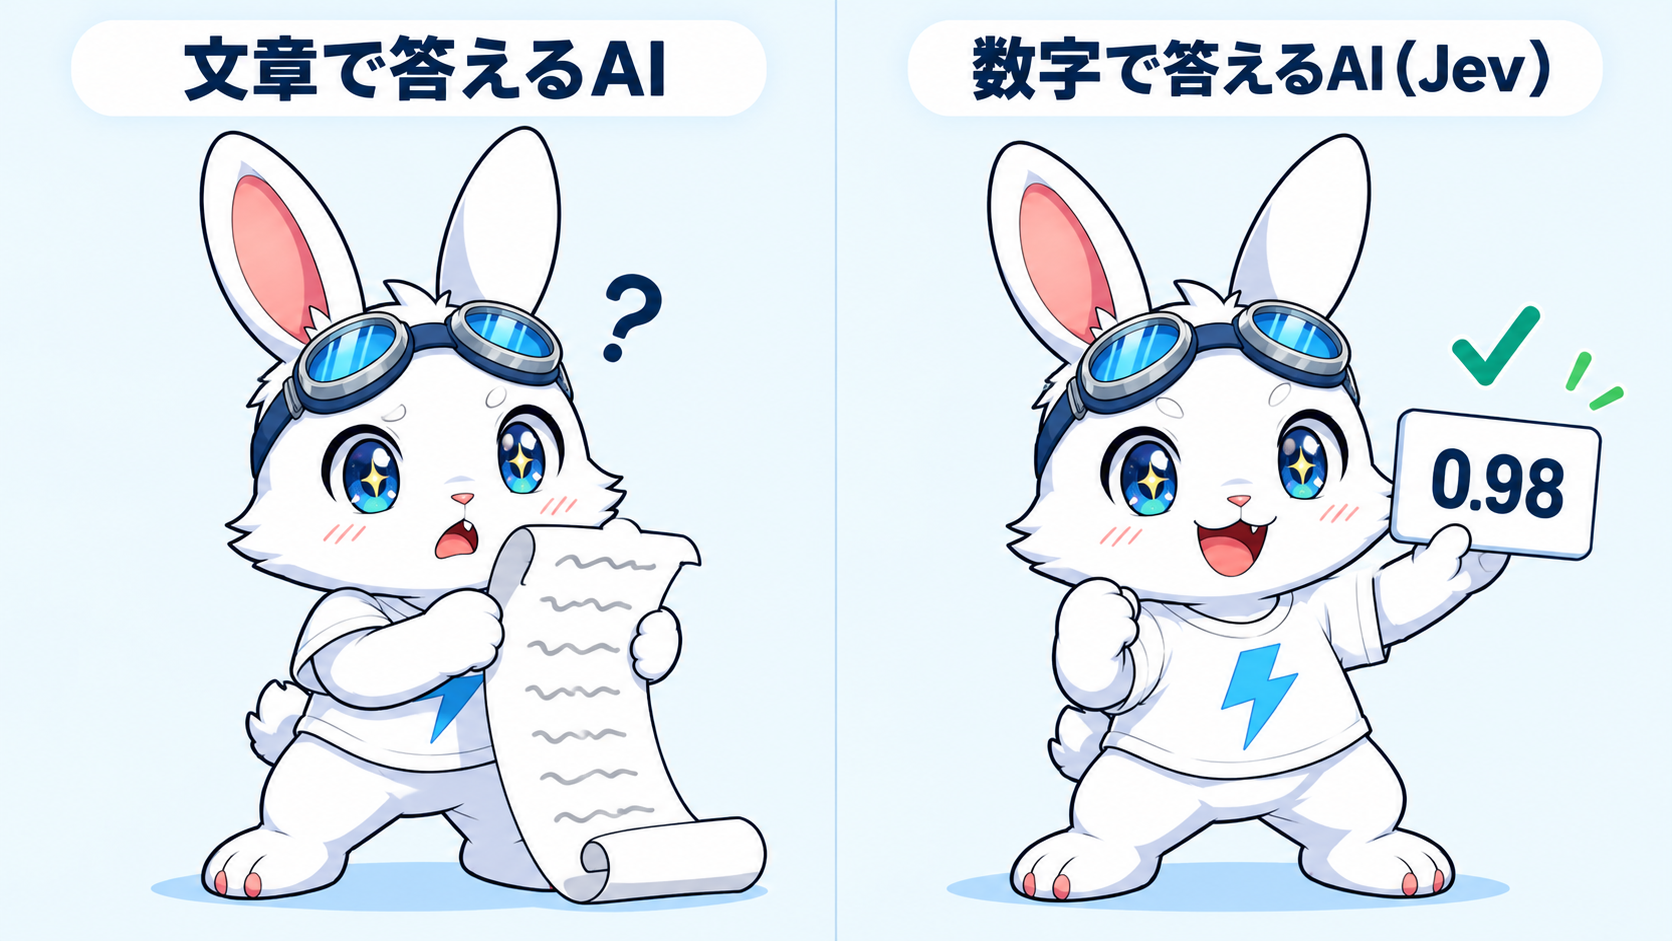
TypeSafe はこれを「System One」のモデルと呼んでいます。じっくり考える側ではなく、パッと判断する側、という意味です。
たとえば、こんな場面で困ったことがある方向けです。
- 問い合わせメールを AI に振り分けさせたら、返事の言い回しが毎回違って、プログラムが拾えなかった
- 「急ぎですか?」と聞いたら「急ぎの可能性があります」と返ってきて、結局どっちなのか分からなかった
Jev は、こういう「判断だけほしい」ところのための道具です。
画面は、「材料」と「質問」の2つだけ
Playground の左側は、上下2つに分かれています。
- State(ステート):判断の材料。問い合わせの文面、書類の中身など
- Questions(クエスチョン):その材料について聞きたいこと
これを入れて「Run request」を押すと、右側に答えが出ます。やることはこれだけです。
どちらも JSON という書き方で入れます。身構えなくて大丈夫です。{ } の中に「”名前”: “中身”」を、カンマで区切って並べるだけ。このあと出てくる例を、ほぼそのまま写せば動きます。
質問には、必ず「型」をつけます。型は3種類あります。
| 型 | 聞き方 | 返ってくるもの |
|---|---|---|
| Noul | これは本当か? | 0〜1の数字(本当らしさ) |
| Choice(チョイス) | どれに当てはまるか? | 選んだ選択肢と、それぞれの確率 |
| Score(スコア) | どの段階か? | 段階の番号と、それぞれの確率 |
最初は Noul だけ覚えれば十分です。「はい/いいえ」を、0〜1の数字で答えてくれるものです。
まず、そのまま聞いてみました
ホットドッグの問いを Noul で書くと、こうなります。
{
  "is_sandwich": {
    "type": "noul",
    "instructions": "Is hotdog a sandwich?"
  }
}
is_sandwich は、答えを受け取るための名前です。自分で好きに付けます。instructions が質問文。
実行すると、こうでした。
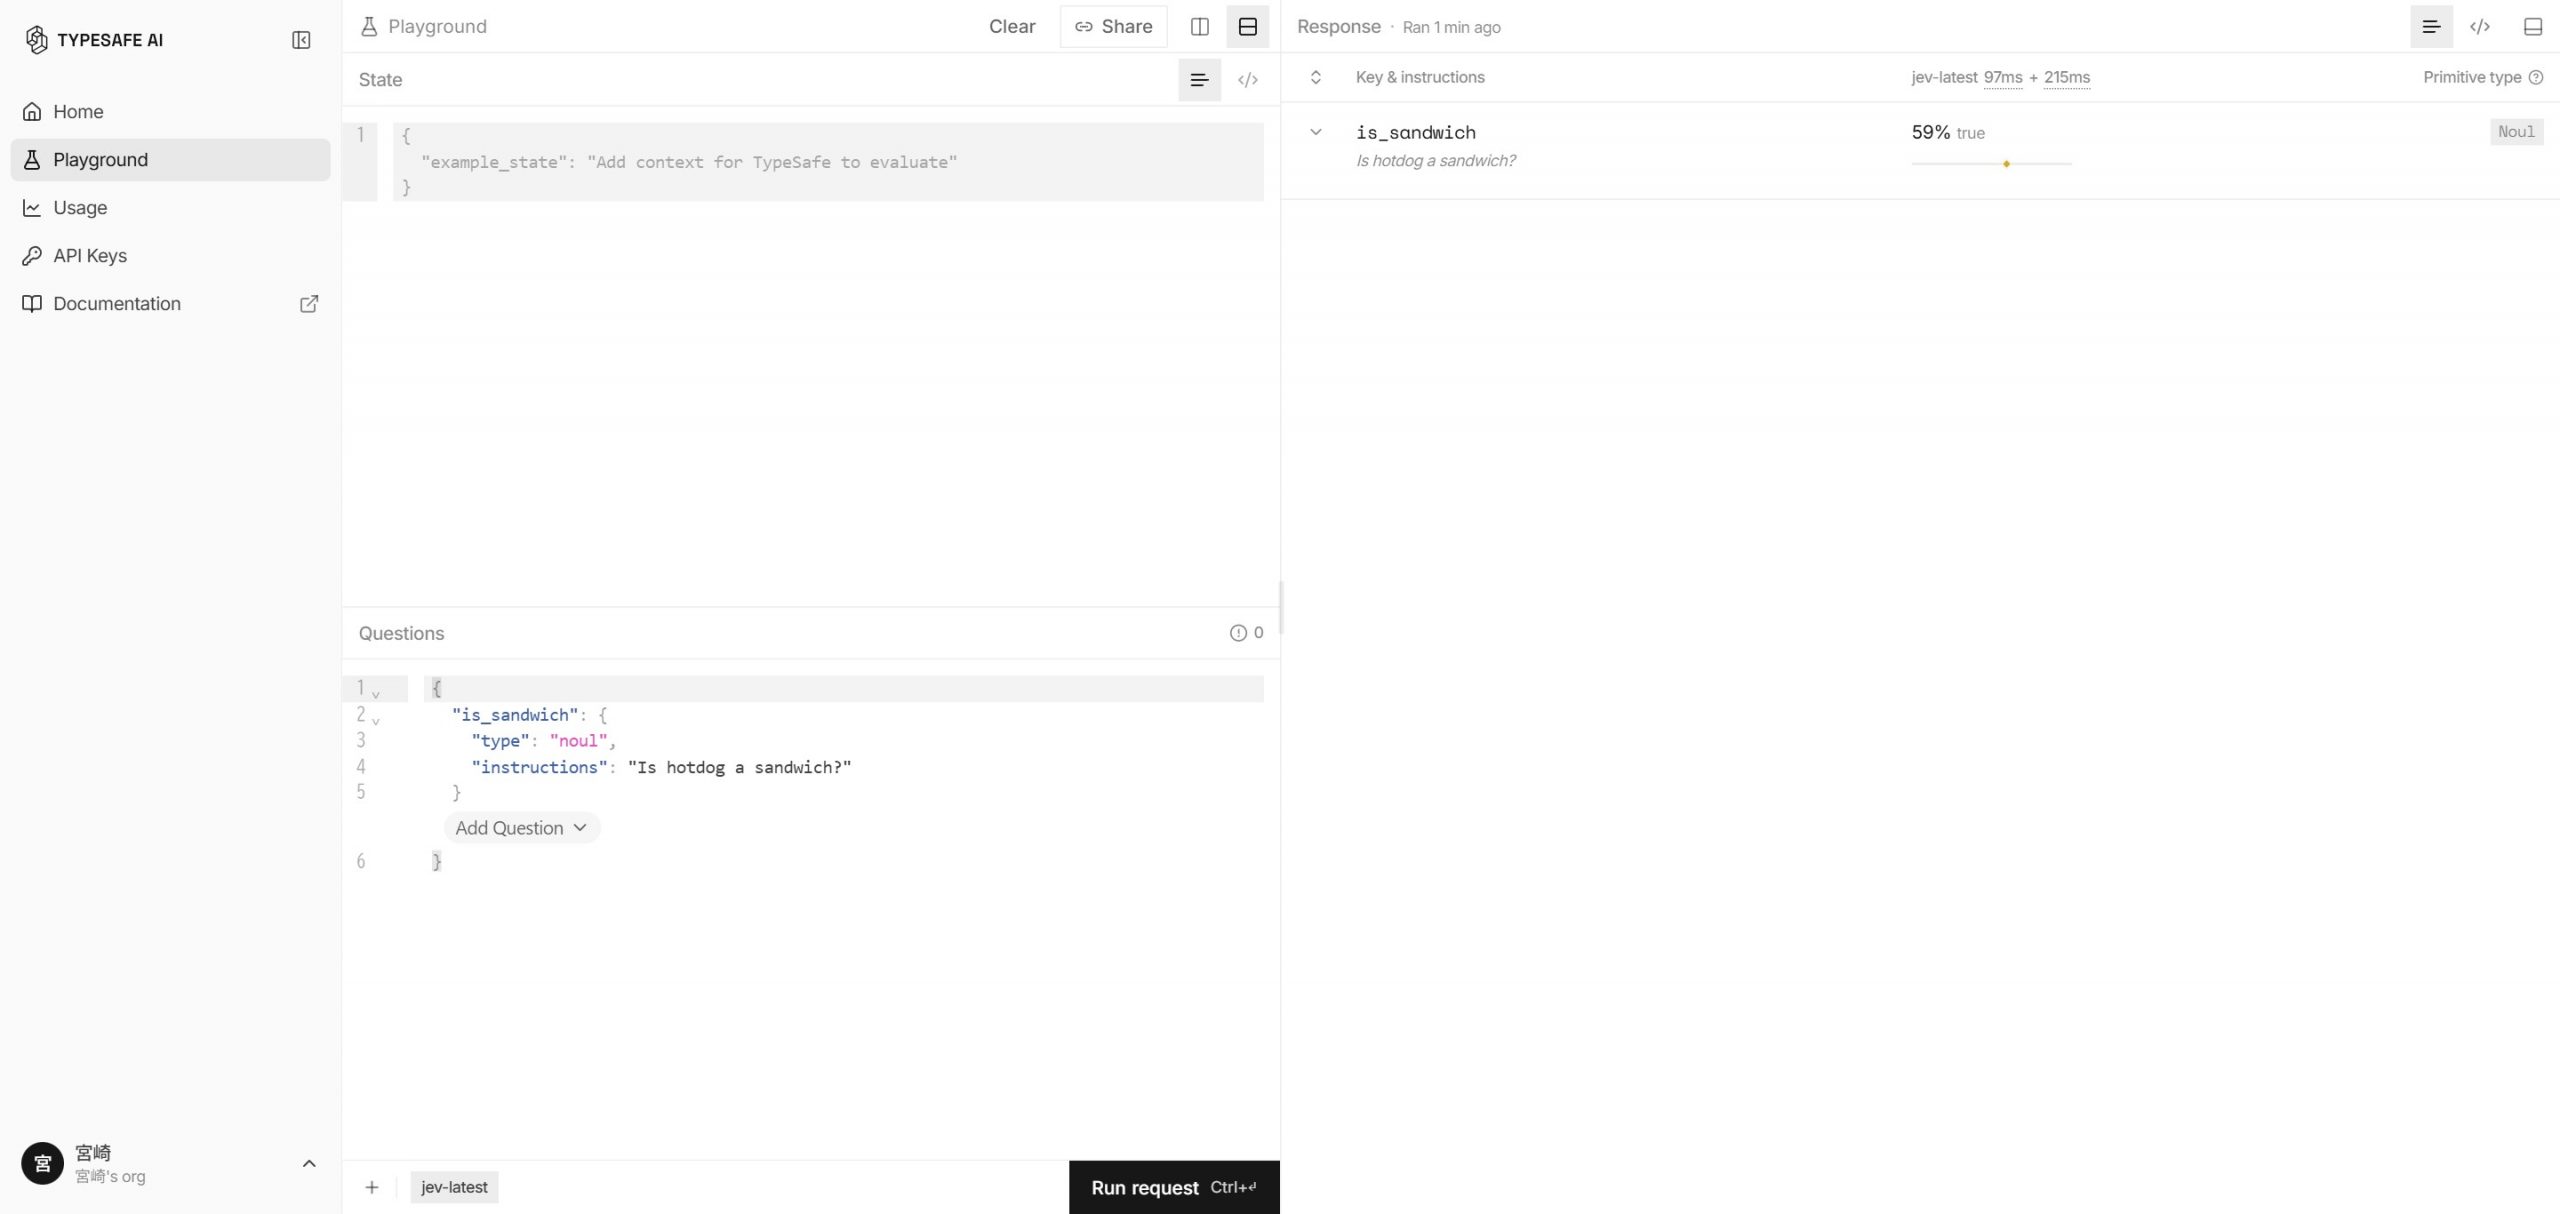
59%。
ウォークスルーの中で流したときは60%でした。レッスンの案内にも「モデルはかなり迷っている」と出ます。
ここ、ちょっと面白いところで。
この59%は、「59%くらいサンドイッチ」という意味ではありません。本当かどうか、五分五分に近いという意味です。ドキュメントにも、0.5は「中くらい」ではなく「はいといいえが同じくらい」だと注意書きがあります。
で、なんで迷うのか。
サンドイッチの定義を言っていないからです。人に聞いても、たぶん意見が割れます。
「何を本当とするか」を書いたら、75%になりました
そこで、判断の基準(criteria)を足します。
- true(本当):肉やチーズなどの具が、パンのような土台に挟まれている食べ物
- false(うそ):具を挟むパンがない、パンが1枚だけ、トルティーヤやクッキーで包んでいる
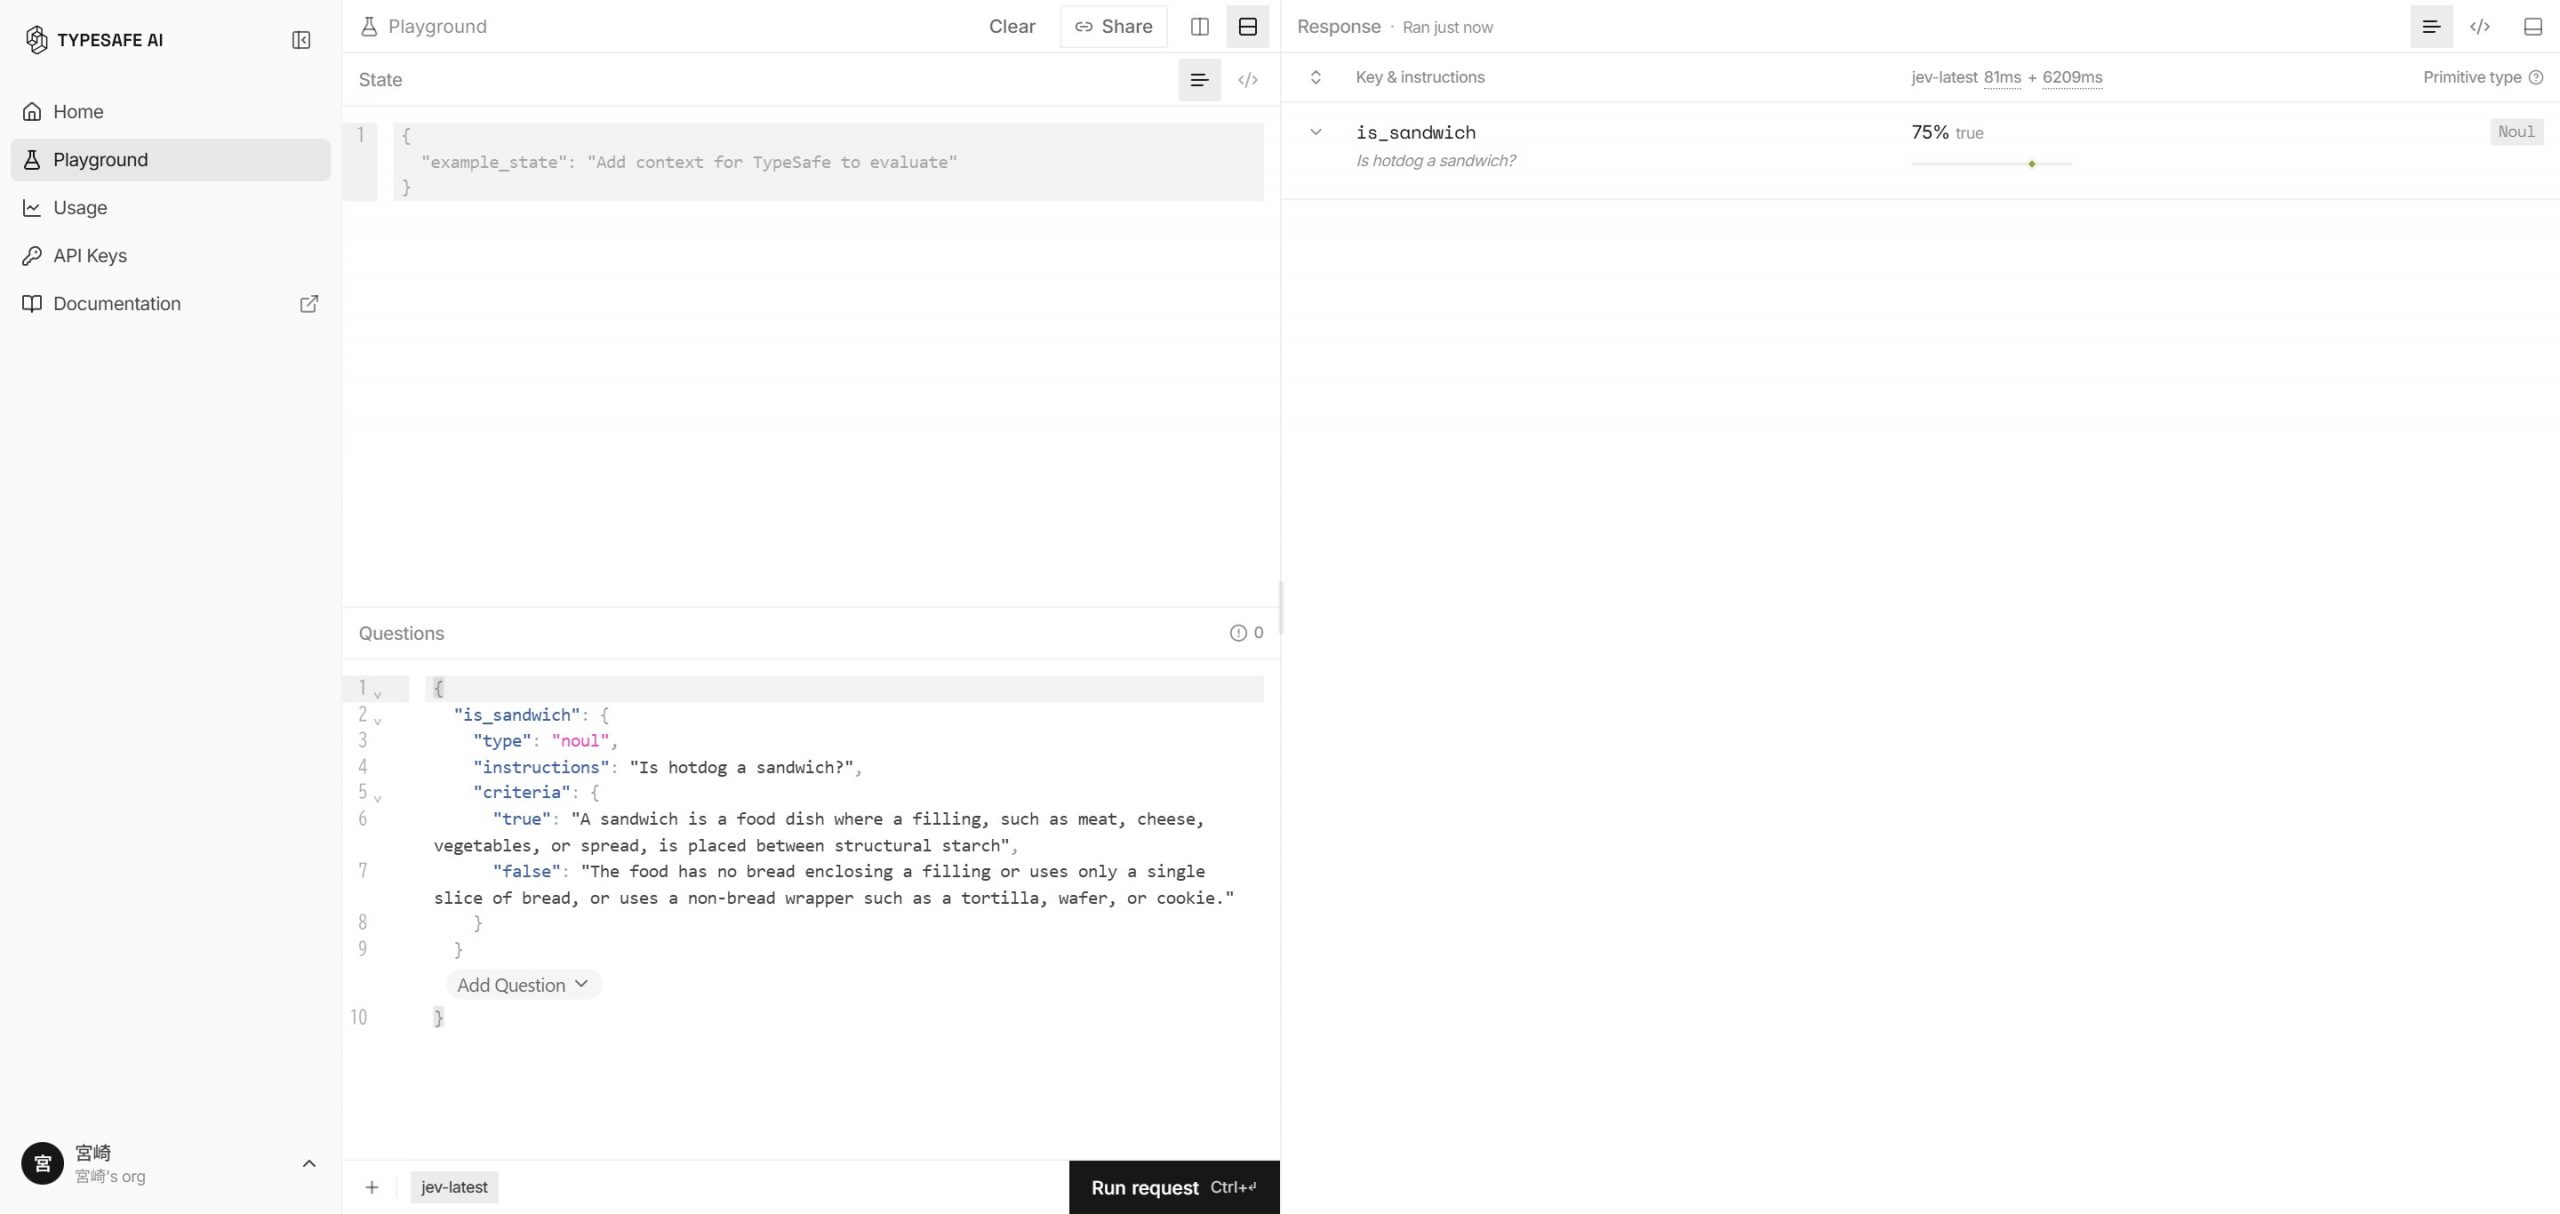
75%。
はっきり上がりました。ホットドッグは、具がパンに挟まっているので。
これが Jev の使い方のコツ、その1です。
迷ったら、モデルを疑う前に、自分の定義を疑う。
「いい感じに判断して」は通じません。何を「はい」とするかを書いた分だけ、答えがはっきりします。これは人に仕事を頼むときと同じだな、と思いました。
材料を差し替えると、同じ質問が使い回せます
次のレッスンは、アイスクリームサンドです。名前にサンドが入っているやつ。
ここで質問の書き方を少し変えます。hotdog を直接書くのをやめて、バッククォート記号で囲んだ food に置き換えます。質問文は「Is food a sandwich?」になります。こう書くと、「State の food を見て」という意味になります。
そして State のほうに、材料を入れます。
{
  "food": "Ice cream sandwich",
  "definition": "An ice cream sandwich is a frozen dessert with a layer of ice cream between two cookies, wafers, or thin pieces of cake."
}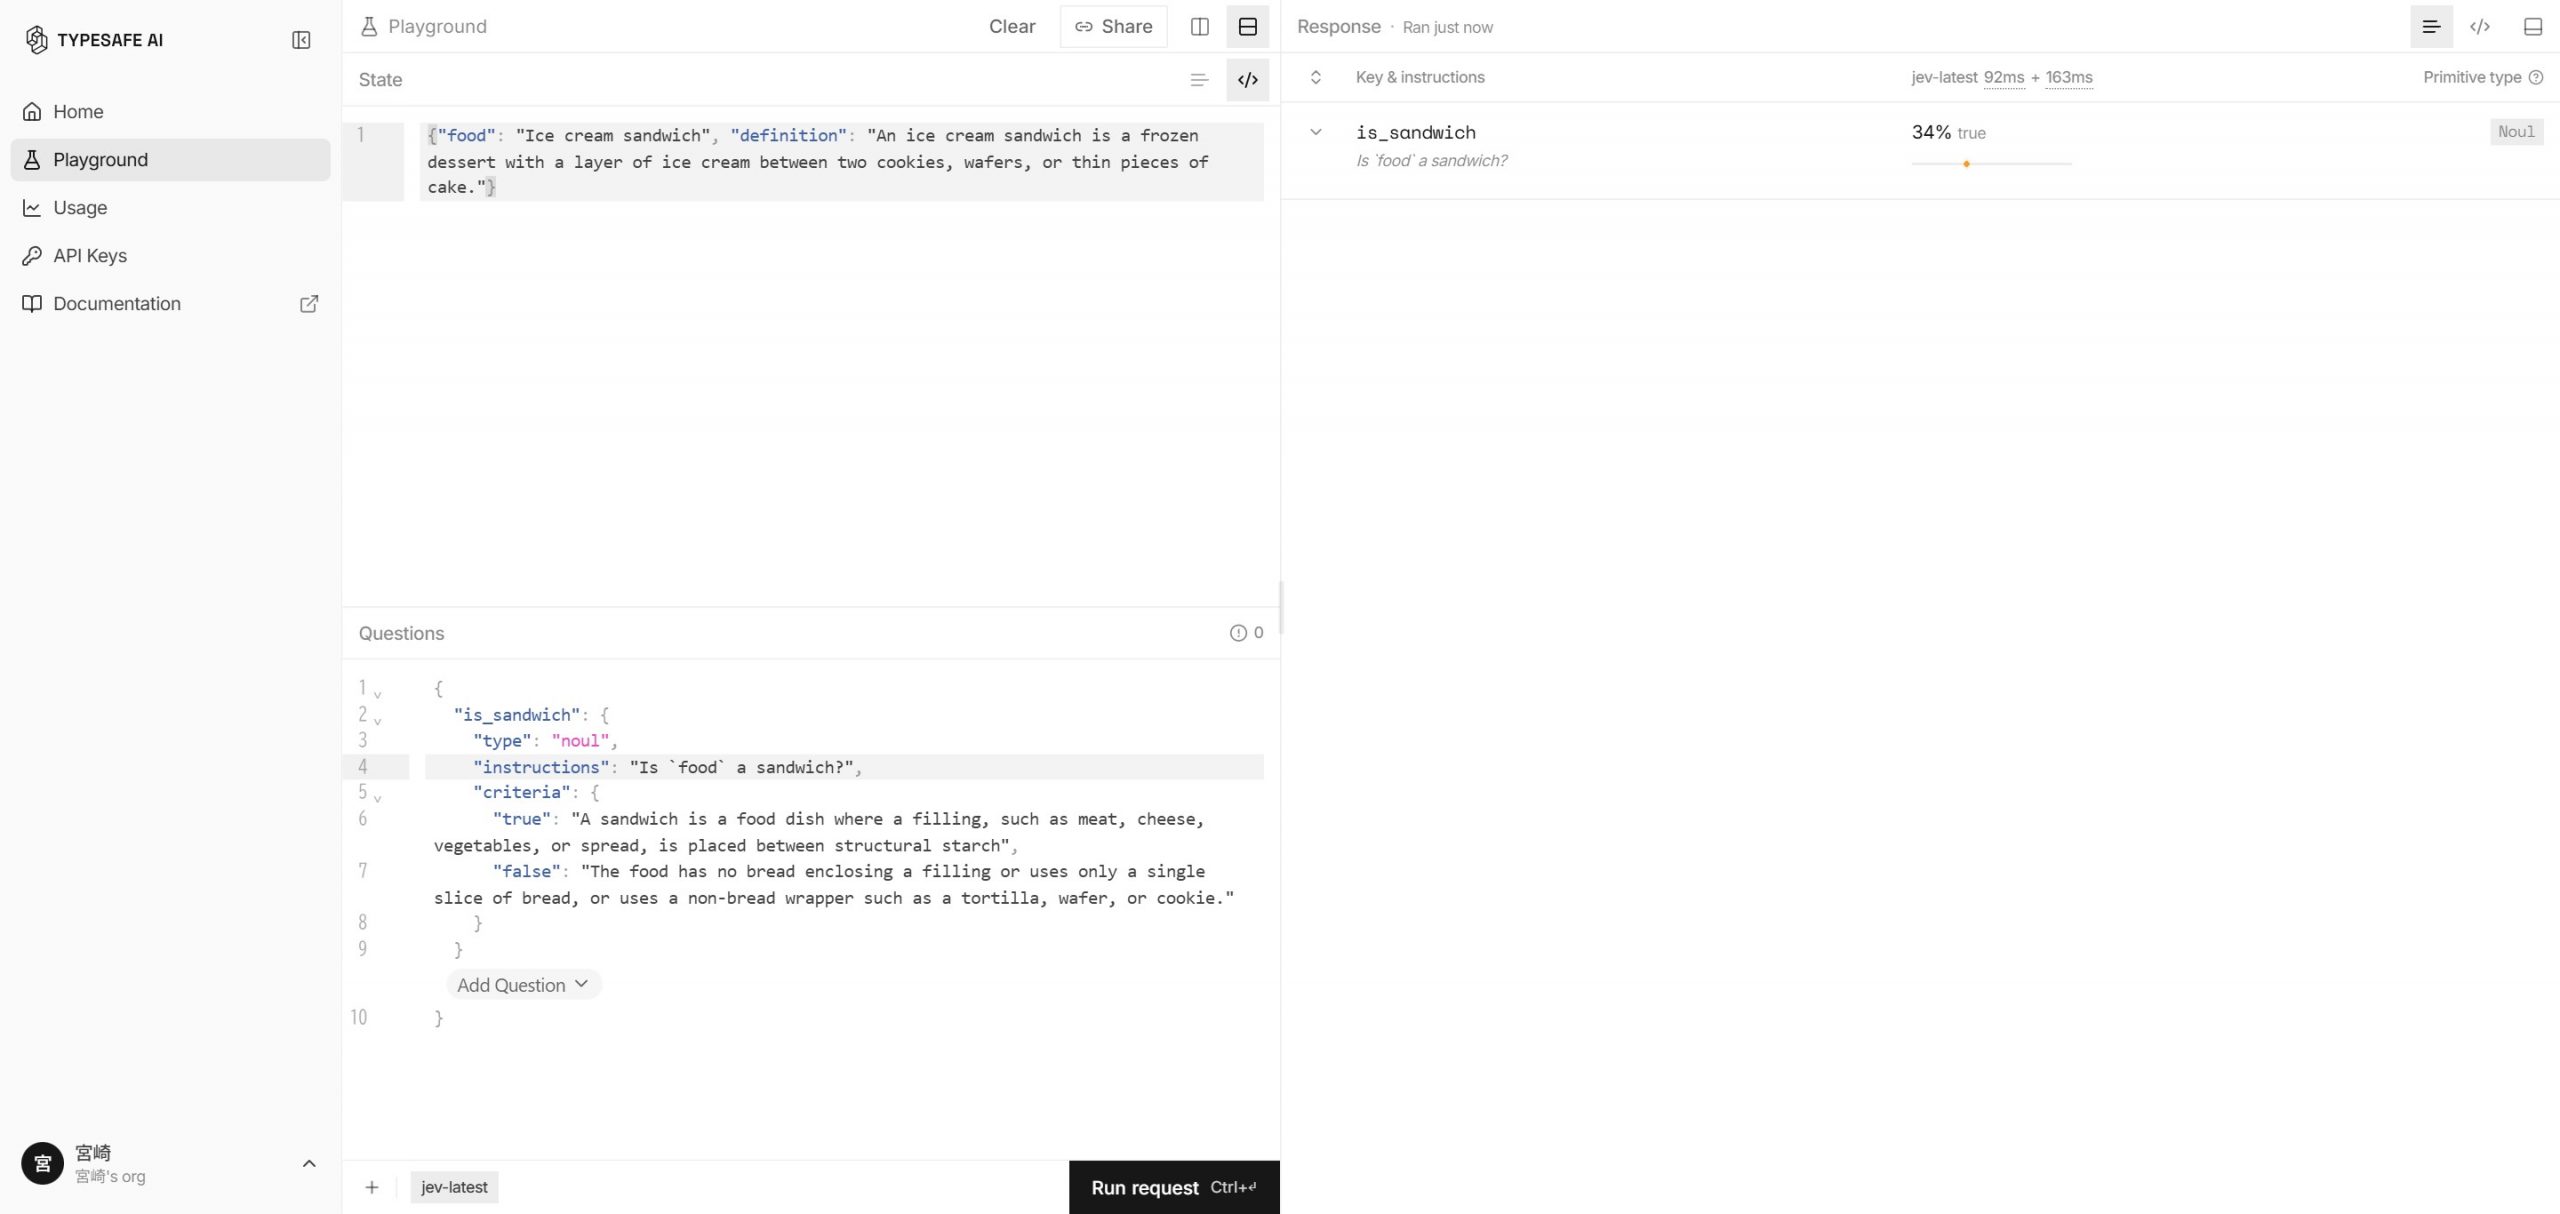
34%。
名前にサンドが入っていても、引っかかりませんでした。さっきの基準で「クッキーやウエハースで包んでいるものは false」と決めていたからです。
コツ、その2です。
質問は固定して、材料だけを差し替える。
こうしておくと、同じ質問を何百件の材料にも流せます。質問文をいじらないので、結果の比べ方もぶれません。
答えの中身は、数字だけでした
右上の </> を押すと、返ってきたデータそのものが見られます。
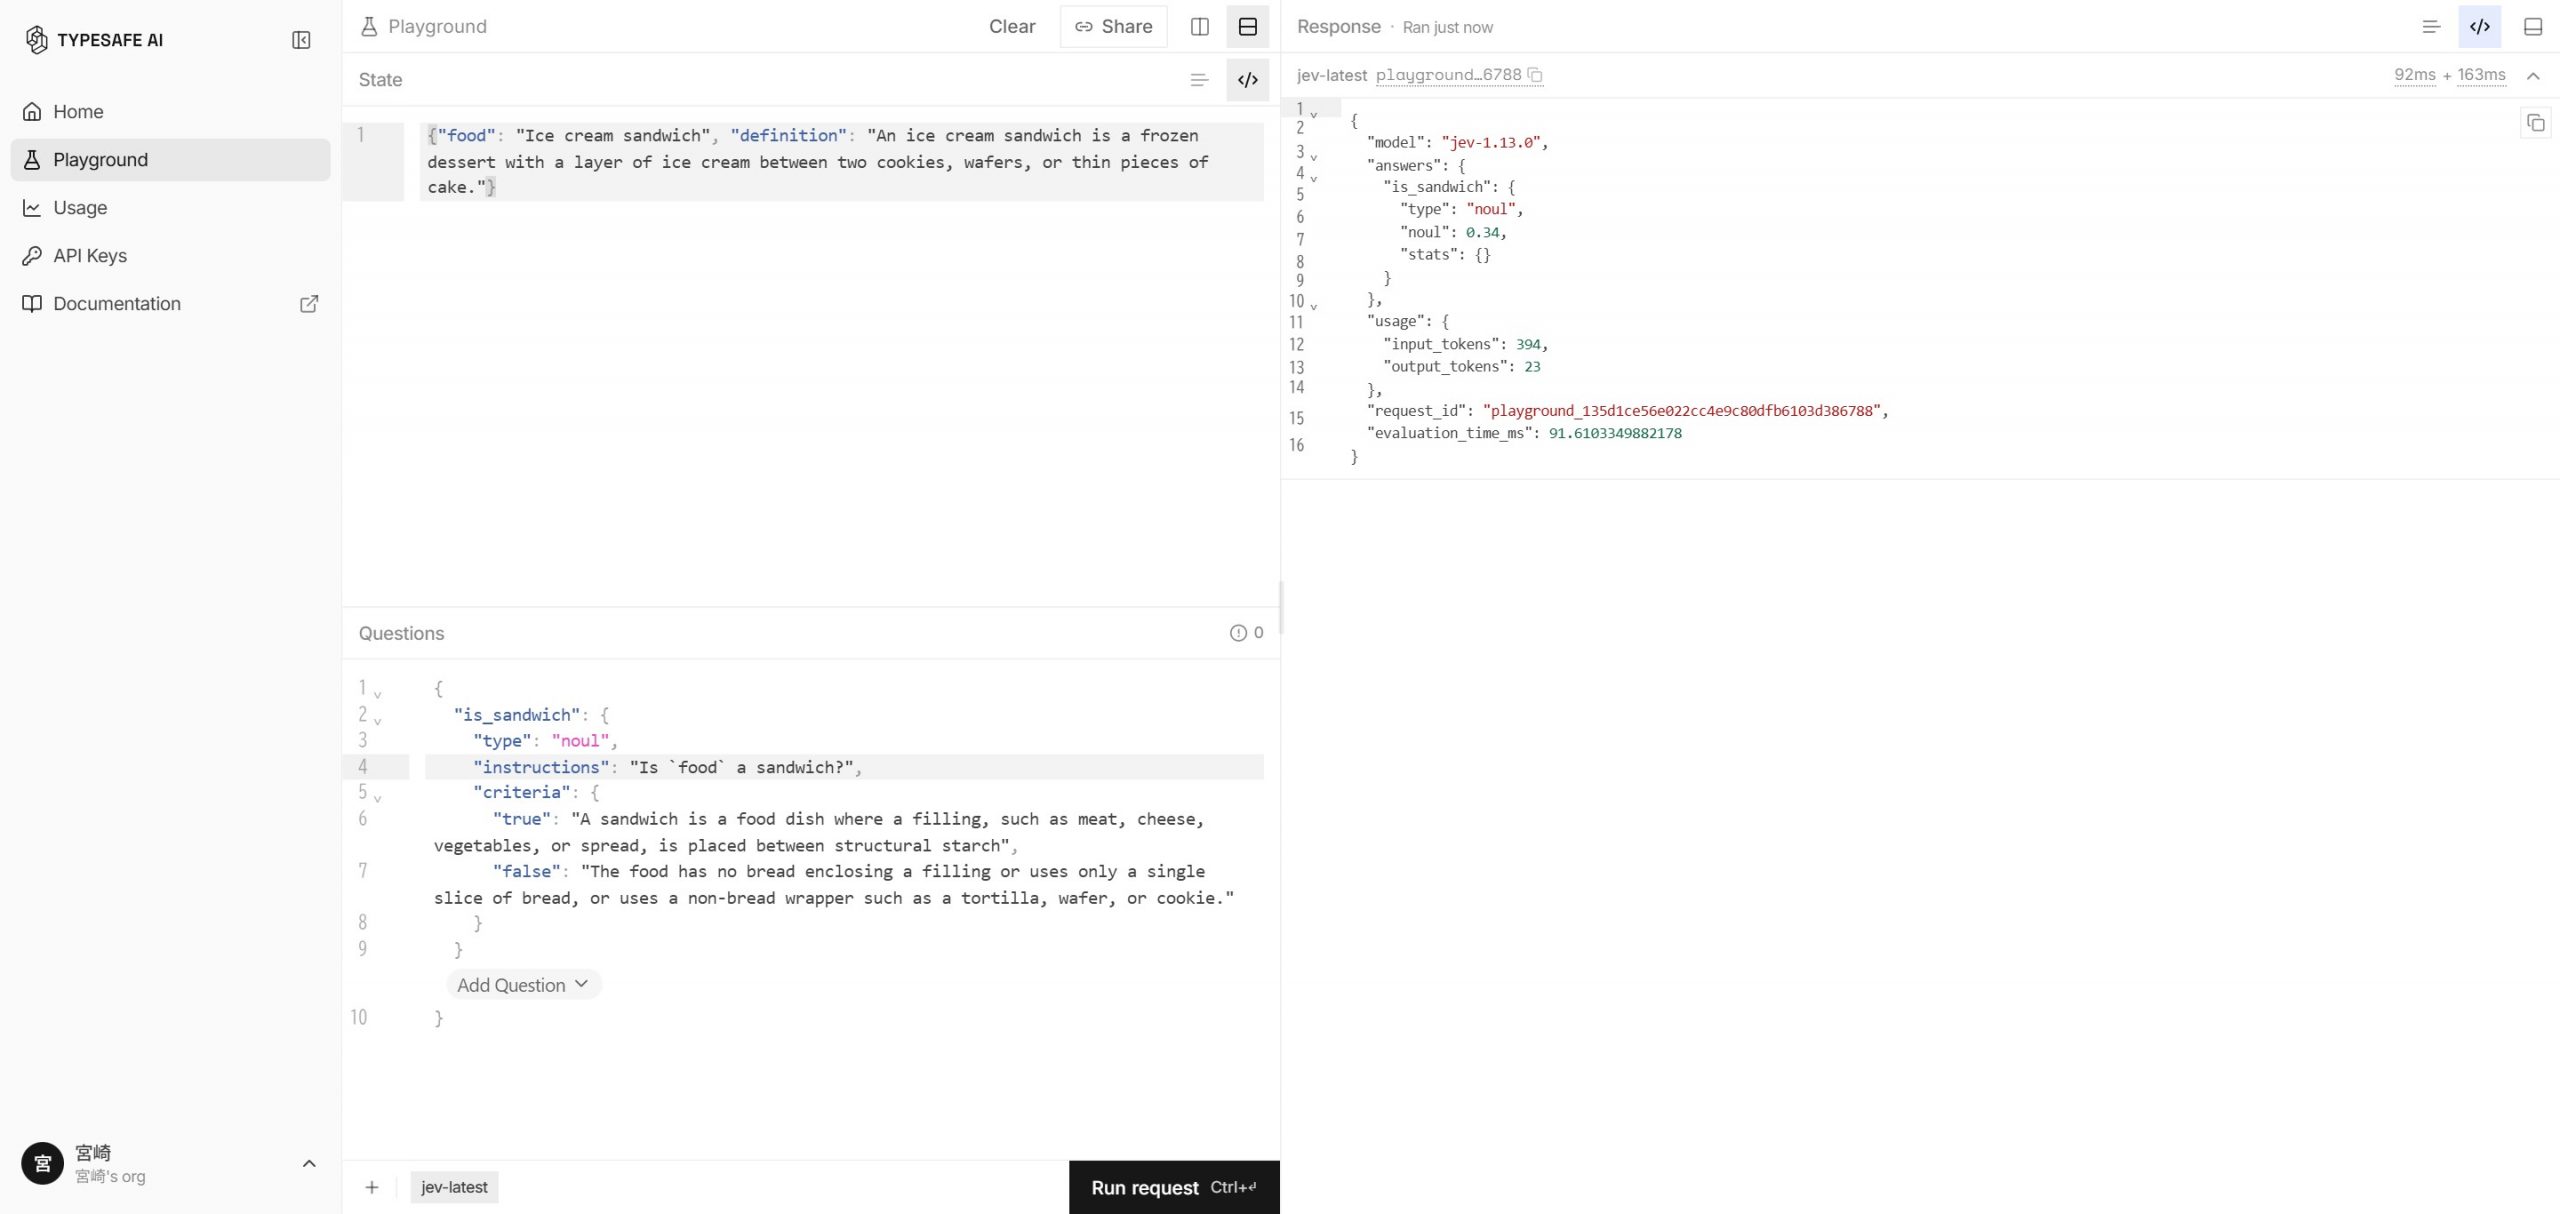
答えの部分は "noul": 0.34。これだけです。
文章がないので、読み解く処理がいりません。プログラム側は「0.5より上なら〜」と書くだけで済みます。
しかも速い。この1問は、評価そのものが0.09秒ほどでした。入力394トークン、出力は23トークンです。
「Claude に JSON で返させればいいのでは?」
ここで、たぶん出てくる疑問です。僕も最初にそう思いました。
Claude や ChatGPT にも、JSON の形で返させる機能はあります。形だけなら、揃えられる。
違うのは、数字の意味です。
TypeSafe は、Jev の数字が「較正(キャリブレーション)」されていることを売りにしています。0.8と出たものを集めると、だいたい8割が本当に当たっている。0.2なら2割。AI入門のページに、そう書いてあります。
チャット向けの AI は、人に好まれる答えを返すように鍛えられています。なので「自信があるように見える」ことと「当たる確率」が、ずれることがある。そこを分けたのが Jev だ、という主張です。
もう1つ、お金の話もあります。
モデルのページによると、料金は入力100万トークンあたり0.042ドル。出力は無料です。このあと試す日本語の問い合わせ(質問3つ)は、1通あたり入力575トークンでした。なので、1万通流しても約0.24ドル。1ドル150円で計算すると、36円くらいです。
大量の「はい/いいえ」を、安く速く、数字で返す。そこに振り切った道具だと思っておくと、ぴったりきます。
日本語の問い合わせでも、試してみました
ホットドッグだけだと、仕事の絵が浮かびにくいと思います。
なので、よくある問い合わせメールで試しました。State に文面を入れて、質問を3つ、型を混ぜて並べます。
- department(Choice):どの窓口が対応すべきか。請求・不具合・営業の3択
- is_urgent(Noul):急ぎの対応を求めているか
- frustration(Score):どのくらい苛立っているか。「落ち着いている」「困っているが丁寧」「強い言葉で怒っている」の3段階
1通目は、これです。
「昨日から見積もりシステムにログインできません。今日の15時までにお客様へ見積書を出さないといけないので、至急対応してもらえますか。先週も同じことがありました。」
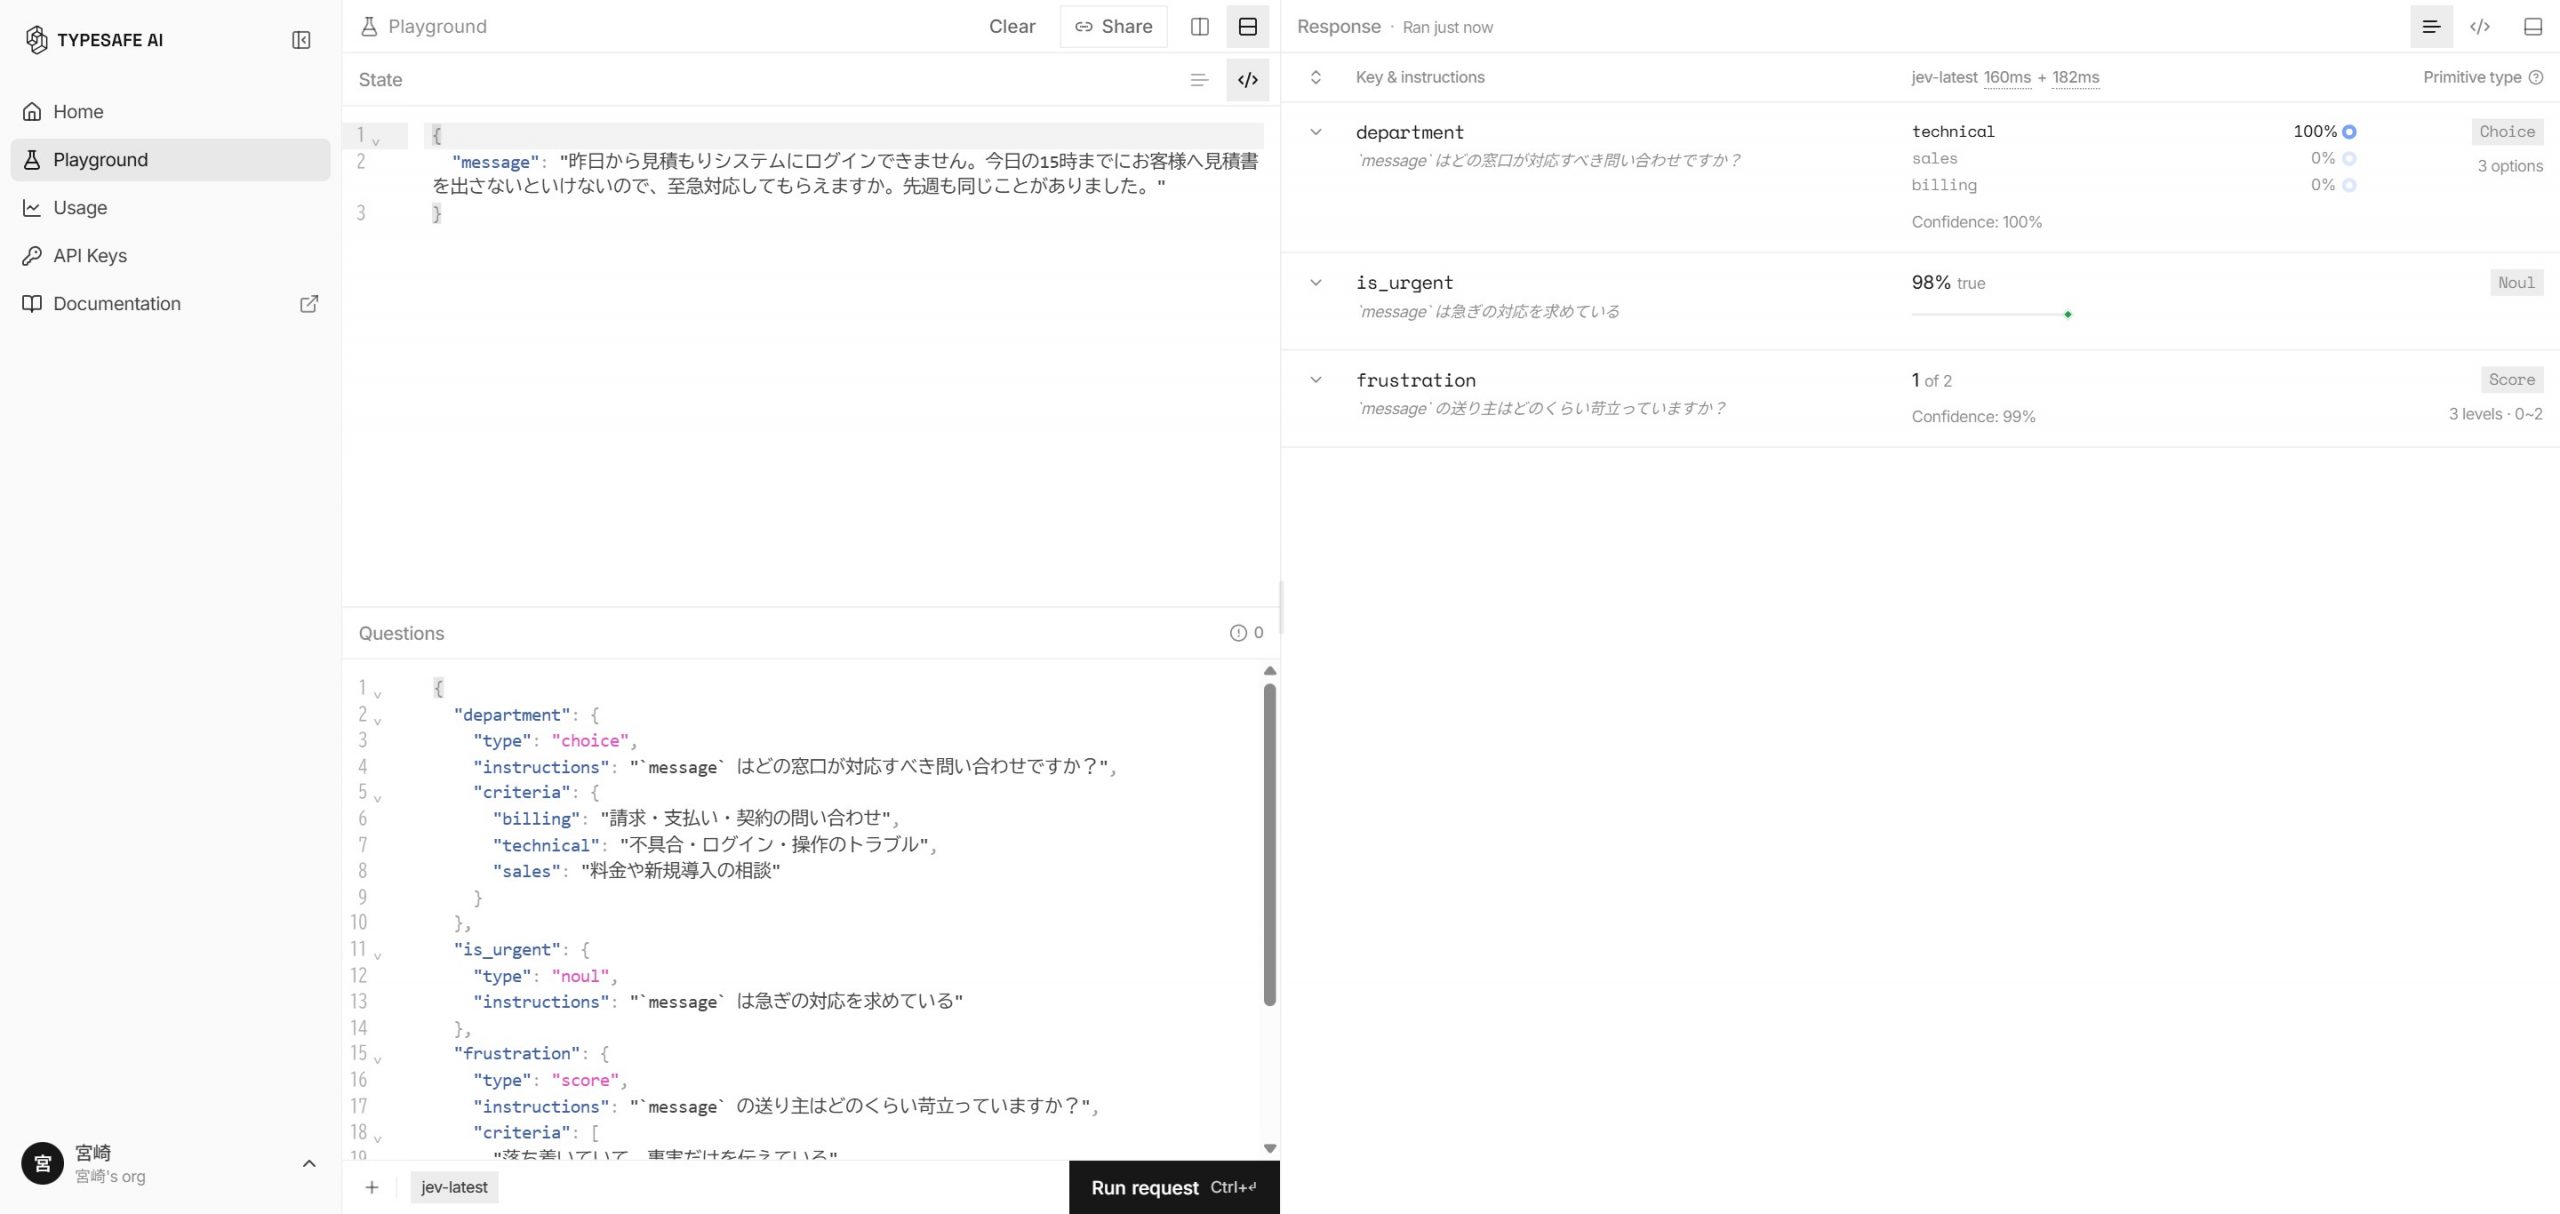
- 窓口:technical(不具合)100%
- 急ぎ:98%
- 苛立ち:1(困っているが丁寧)、確かさ99%
うん、合ってる。
「先週も同じことが」と書いてあるので、怒り寄りに出るかなと思っていました。でも言葉づかいは丁寧なので、真ん中の段階。これも納得です。
JSON で見ると、Choice と Score には確率の内訳と、どれだけ確かかを表す confidence が付いてきます。
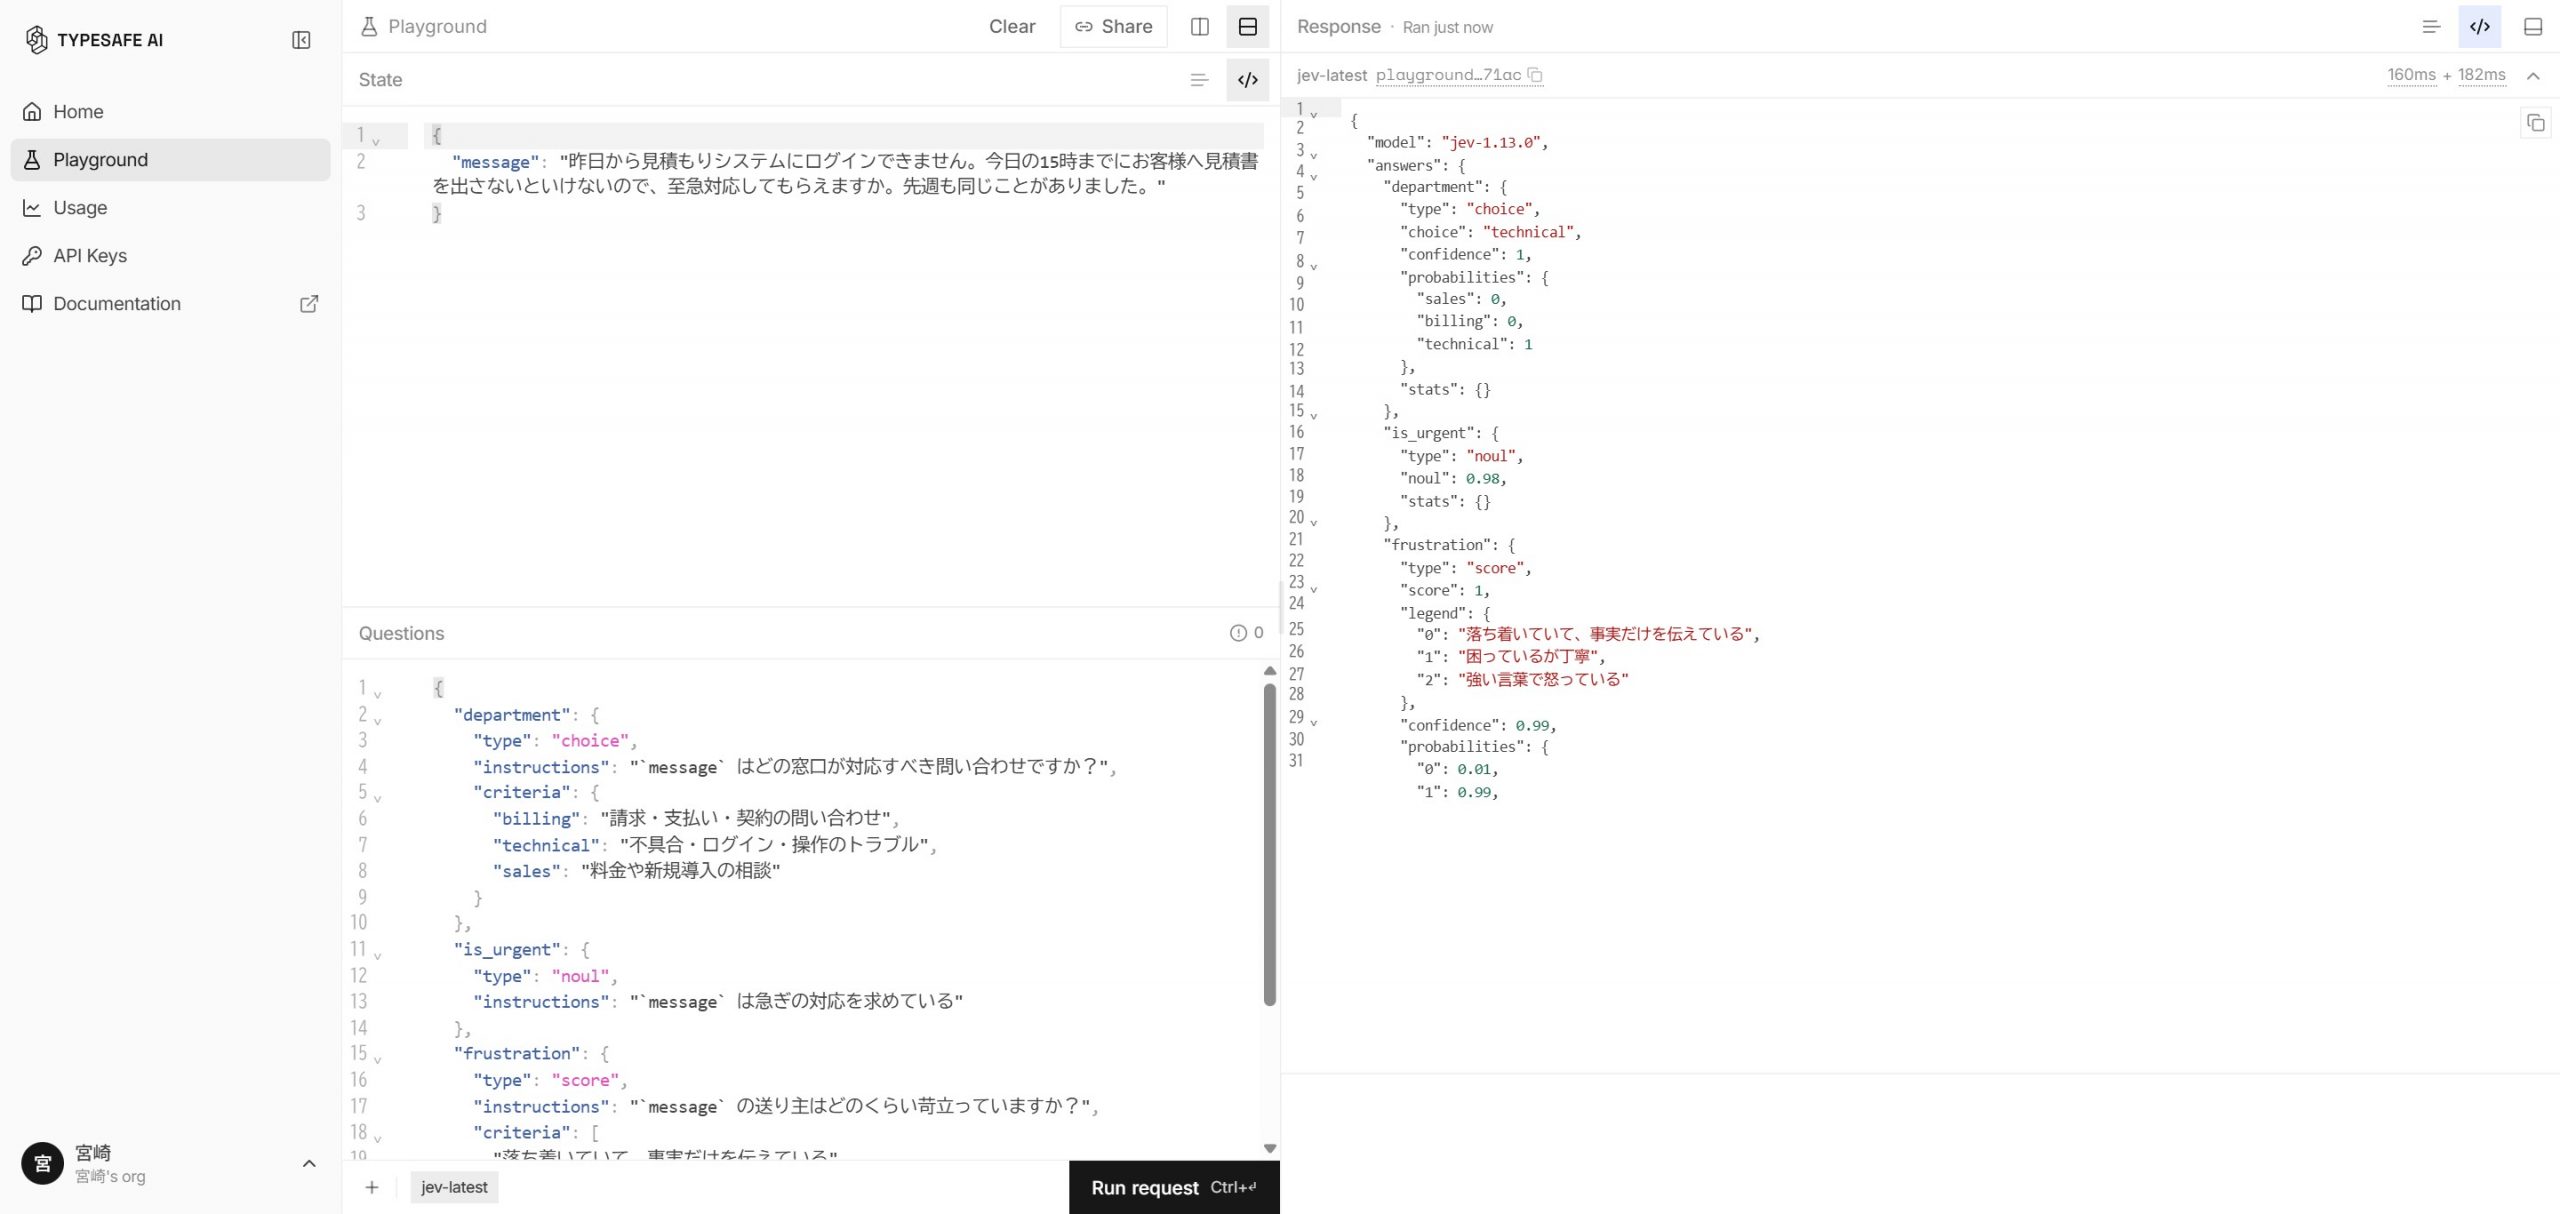
2通目は、温度の違う問い合わせにしました。
「来月から社員5名で使ってみたいと考えています。月額の料金表があれば送っていただけますか。急ぎではありません。」
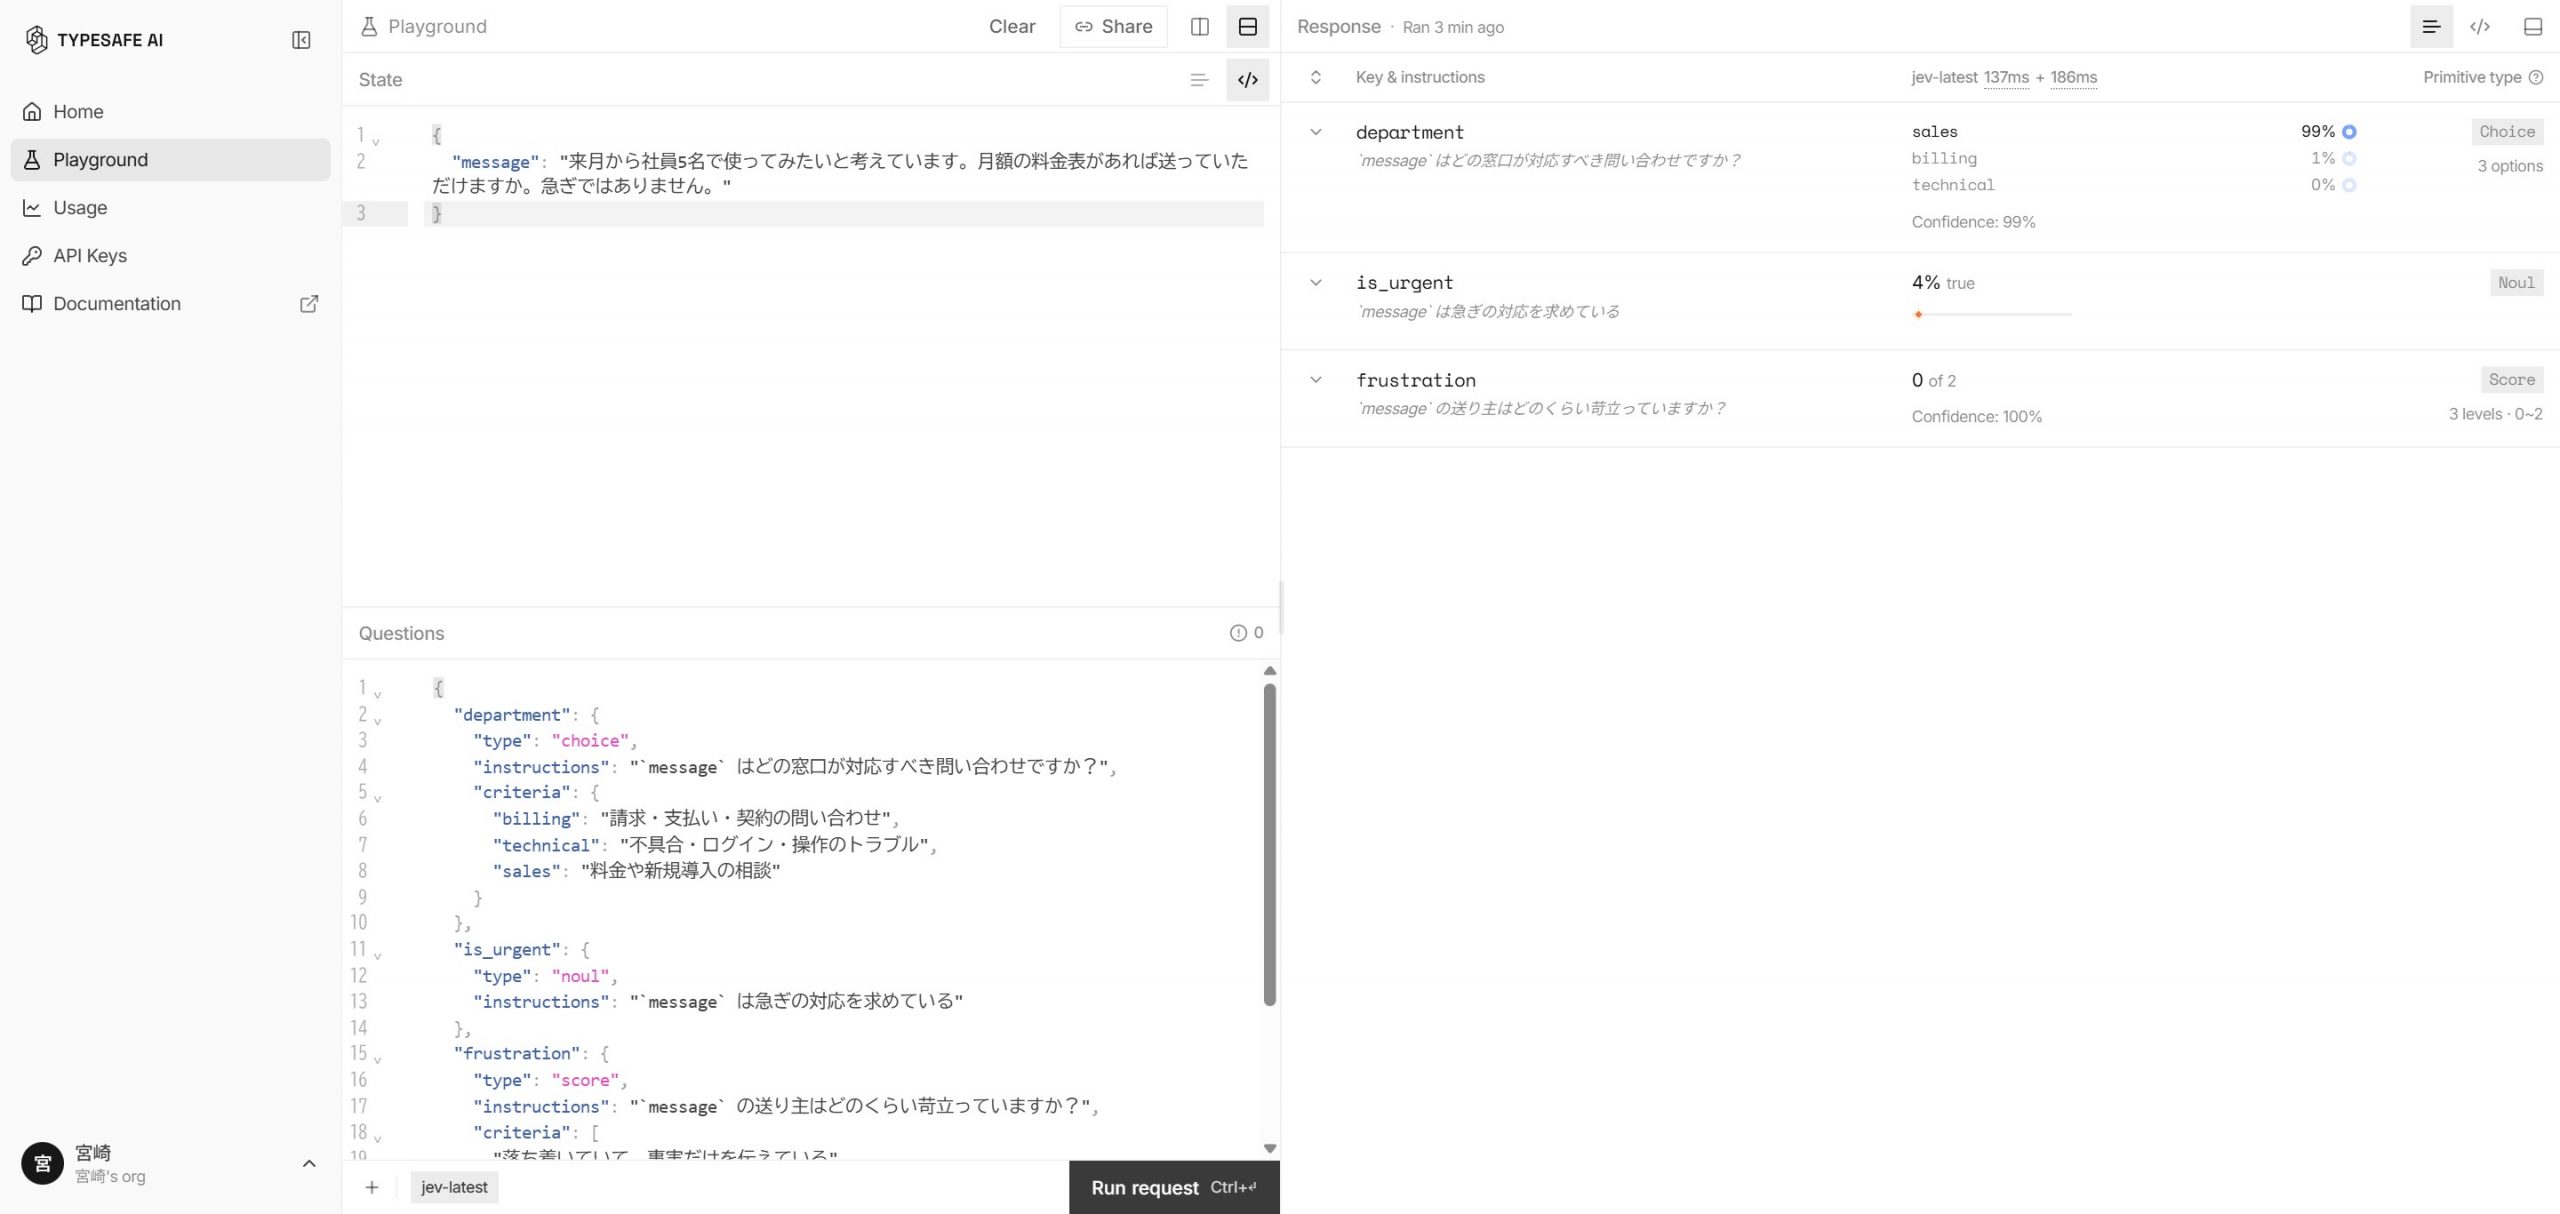
- 窓口:sales(営業)99%
- 急ぎ:4%
- 苛立ち:0(落ち着いている)、確かさ100%
質問はまったく同じで、材料だけ替えました。それで、ここまで分かれます。
ただ、試したのはこの2通だけです。TypeSafe のドキュメントには、日本語でどのくらい当たるかは書かれていません。仕事で使う前に、自社の実際のメールを数十通流して、人の判断と比べてみるのをおすすめします。
数字を受け取ったら、どうするか
数字が返ってくるのはいい。で、それをどう使うのか。ここが抜けると、結局「なんとなく」に戻ります。
確かさ(confidence)のページに、目安が書いてありました。
| confidence | どうするか |
|---|---|
| 0.9より上 | そのまま自動で進めてよい |
| 0.5〜0.9 | 進めるなら、人の確認をはさむ |
| 0.5より下 | 自動では動かさない。人に回す |
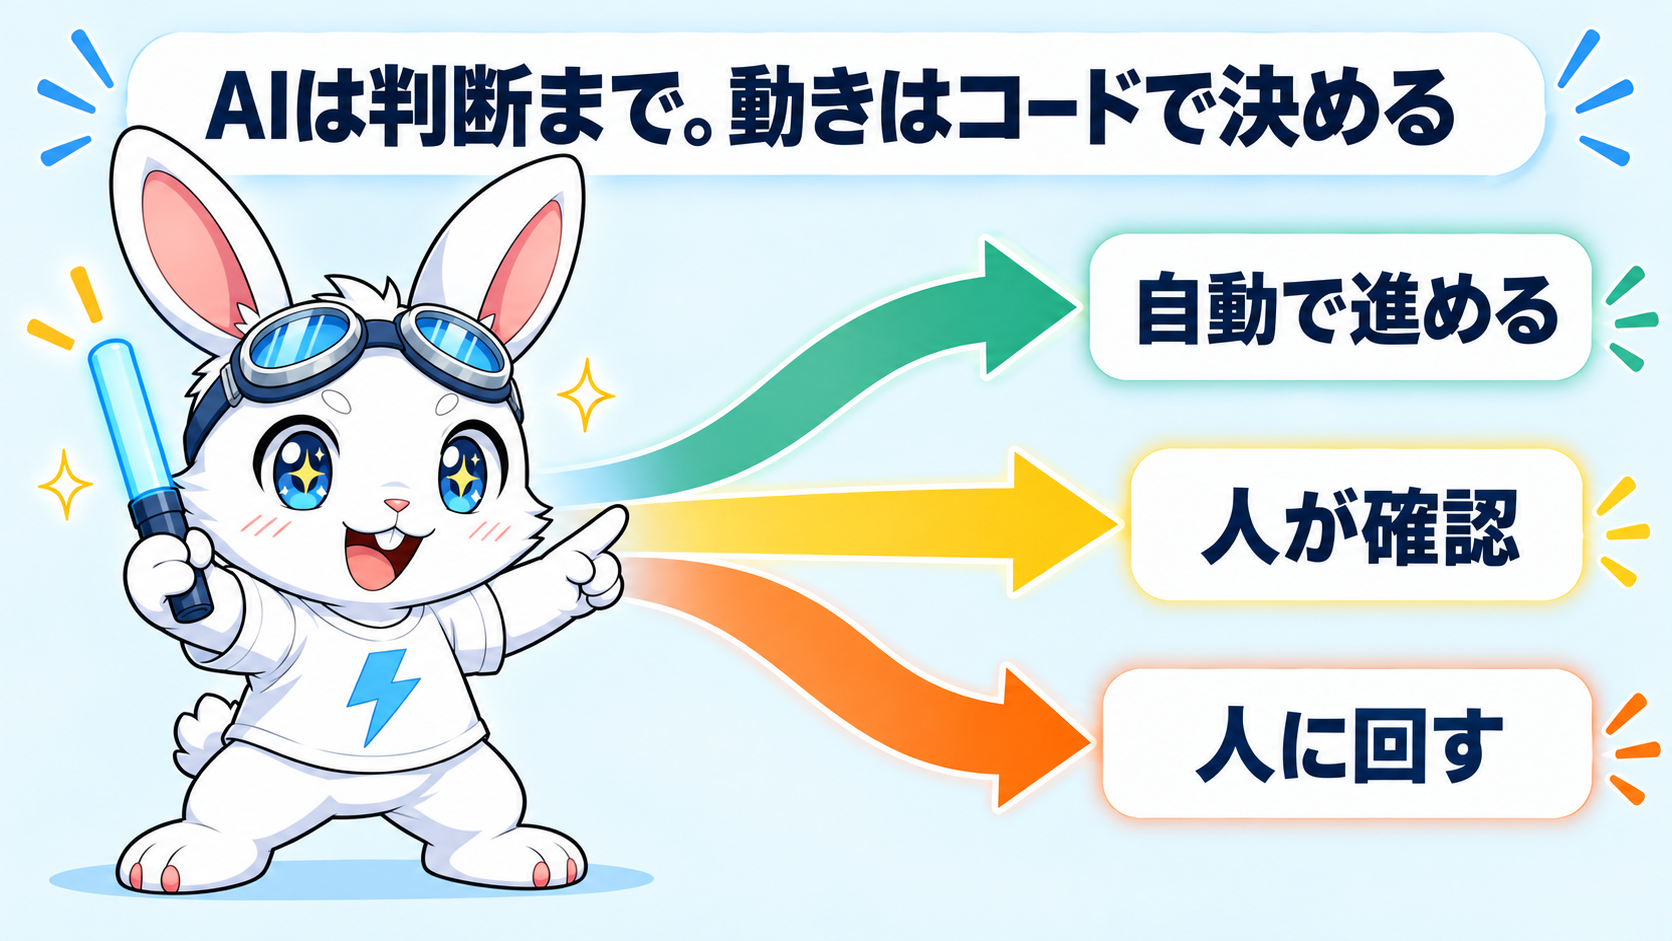
ただし、この境目は仕事の中身で変えるもの、とも書いてあります。間違えたときの痛さで決める。窓口の振り分けなら多少外れても直せますが、返金やデータの削除は、そうはいきません。
Noul には confidence が付きません。数字そのものが「本当らしさ」なので、どこで線を引くかを自分で決めます。取りこぼしが困るなら線を下げる。誤検知が困るなら上げる。
プログラムにすると、これくらいです。Python の例です。
from typesafe_sdk import Choice, Noul, TypeSafeClient
client = TypeSafeClient()
res = client.system_one(
    state={"message": message},
    questions={
        "department": Choice(
            instructions="`message` はどの窓口が対応すべき問い合わせですか?",
            criteria={
                "billing": "請求・支払い・契約の問い合わせ",
                "technical": "不具合・ログイン・操作のトラブル",
                "sales": "料金や新規導入の相談",
            },
        ),
        "is_urgent": Noul(instructions="`message` は急ぎの対応を求めている"),
    },
)
dept = res.answers["department"]
if dept.confidence < 0.9:
    send_to_human(message)          # 自信がないときは人へ
elif res.answers["is_urgent"].noul > 0.8:
    notify_now(dept.choice)         # 急ぎは、すぐ担当に通知
else:
    add_to_queue(dept.choice)       # それ以外は、窓口ごとの列へ
send_to_human などは、自分の仕組みに合わせて書く部分です。AI の仕事は判断まで。そのあとどう動くかは、コードに書いておく。 これが Jev の使い方の芯だと思いました。
使う前に、僕が勘違いしていたこと
触る前は、「賢いチャットAIの一種」だと思っていました。違いました。
1問に、1つの判断だけを聞く。
ドキュメントに何度も出てくる考え方です。詳しい人が数秒で判断できるくらいの問いにする。「このメッセージは急ぎか?」はいい問い。「このメッセージを分析して最善の対応を決めて」は、よくない問い。
Noul でも同じです。「怒っていて、かつ返金を求めているか」のように条件を2つ入れると、数字の意味がぼやけます。分けて聞きます。
大きな判断をしたいときは、小さい質問に分けて、組み合わせはプログラム側でやります。たとえば「この問い合わせの優先度」なら、窓口・急ぎ・苛立ちを別々に聞いて、重みを付けて足す。重みを変えたくなったら、質問ではなく数式を直せばいい。
もう1つ、地味だけど大事なこと。
質問の名前(is_urgent など)は、モデルには送られません。
名前で意味が伝わる気がしてしまいますが、伝わっていません。聞きたいことは、全部 instructions に書きます。
それと、質問を増やしても待ち時間はほとんど変わらない、と書いてあります。1つのリクエストの中で、質問ごとに並べて、別々に評価されるからです。なので「使うか分からない質問も、まとめて聞いておく」が推奨されていました。これはプリミティブのページに詳しくあります。
苦手なことも、はっきり書いてありました
ここは正直、好感が持てたところです。TypeSafe は、Jev 1.13 の苦手なことを1ページにまとめて公開しています。
- 計算と数えること。 「電卓ではない」と書いてあります。合計や件数は、コードで出します
- 日付の比較。 日付を数ではなく文字として読むので、「期限を過ぎているか」のような判断は外しやすい
- 材料に関係ない情報が多いとき。 判断に関係ない文が増えるほど、当たりにくくなります。State には、判断に要る部分だけを入れる
- 何段も推論が要る問い、二重否定。 「〜でないとは言えない」のような聞き方は避ける
- 文章を書くこと。 そもそも、そのための道具ではありません
それと、読めるのは文字だけです。画像や音声は入れられません。1回に送れる量にも上限があって、材料と、いちばん長い質問1つを合わせて3万2千トークンまでです(モデルのページ)。長い契約書を丸ごと入れるより、段落ごとに分けて聞くほうが向いています。
会社のデータを入れる前に
問い合わせメールには、お客様の名前や連絡先が入っています。外のサービスに送る前に、扱いは確認しておきたいところです。
TypeSafe の法務のページには、利用者のデータでモデルを学習しない、とあります。データを何日残すかはデータ処理契約(DPA)に書かれていて、企業向けには「データを残さない」設定の相談窓口もあるそうです。
僕なら、最初は個人名やメールアドレスを伏せた文面で試します。本番で使うなら、プライバシーポリシーとDPAを社内で一度読んでから、です。
この「どこに何日残るか」の確かめ方は、前に別の記事でまとめました。
▼関連記事
そのデータ、どこに何日残りますか? 「うちの顧客データを入れて、大丈夫なんですか?」
僕なら、こういうところで使います
今回試した範囲からの、僕の読みです。
- 問い合わせフォームの振り分け。窓口と急ぎを決めて、担当に回す
- 申請書や報告書のチェック。「必要な項目が書かれているか」を Noul で並べる
- アンケートの自由記述の仕分け。Choice で分類して、件数はコードで数える
どれも、人が1件ずつ読むと時間がかかるけど、1件ごとの判断は数秒で済むものです。そこに向いている。
逆に、文章を作ってほしいときや、じっくり考えてほしいときは、今まで通り Claude や ChatGPT を使えばいい。役割がそもそも違います。問い合わせなら、Jev で振り分けて、返信の下書きは Claude に書かせる、という組み合わせもできます。
モデルごとの向き不向きは、ベンチマークの記事でも書きました。
▼関連記事
【2026年9月版】主要AIモデル ベンチマーク徹底比較
始めるなら、この順番で
- Playground で、ホットドッグのレッスンを通す。案内に沿ってクリックしていくだけで、僕は数分で終わりました
- 自分の仕事の文面を State に貼って、質問を1つだけ書いてみる。最初は Noul がおすすめです
- プログラムから使うなら、API Keys で鍵を作って、
pip install typesafe-sdkで Python の道具を入れる。鍵はTYPESAFE_API_KEYという環境変数に入れておくと、自動で読んでくれます(クイックスタート)
API がそもそも何か、というところからなら、こちらの記事が入口です。
▼関連記事
APIってなに?「天気アプリ」で体験する、ネットからデータを取ってくるしくみ
要するに、覚えることはこれだけです
- Jev は文章を書かない。答えは数字と選択肢で返ってくる
- 迷った答えが出たら、判断の基準(criteria)を書き足す
- 質問は固定して、材料(State)だけを差し替える
- 1問に1つの判断。組み合わせと、そのあとの動きはコードに書く
数字の前提
画面と数字は、2026年9月23日に TypeSafe AI の Playground で、弊社のアカウントから実行したものです。モデルは jev-latest(応答の表示は jev-1.13.0)。同じ問いを流し直すと、1ポイント前後揺れました(ホットドッグは60%と59%)。料金は、同日時点のモデルのページの公開単価(入力100万トークンあたり0.042ドル・出力無料)と、1ドル150円で計算した目安です。
作りながら覚えたい方へ
AI に「何を任せて、何をコードに残すか」は、説明を読むより、自分の仕事で1回組んでみたほうが早く分かります。うちは各地でその場を用意しています。
- 岡山では、「使い方より、任せ方」という話をしてきました。→ 岡山ももスタ「明日から使える」AI解体新書 登壇レポート
- 香川では、非エンジニアの方が1ヶ月で「作る側」に回りました。→ AI×ノーコード ブートキャンプ2026(香川)開催レポート
- 2026年10月9日は福岡です。地域の中小企業と生成AIの話をします。→ 大名カンファレンス登壇のお知らせ
問い合わせの振り分けや書類チェックに AI を入れたい、というご相談もお受けしています。「どこから手を付ければいいか分からない」という状態から始めて大丈夫です。
出典
- TypeSafe AI Playground: https://console.typesafe.ai/playground
- TypeSafe AI Docs「Introduction」: https://docs.typesafe.ai/introduction
- TypeSafe AI Docs「Quick start」: https://docs.typesafe.ai/introduction/quickstart
- TypeSafe AI Docs「Primitives (Questions)」: https://docs.typesafe.ai/primitives
- TypeSafe AI Docs「Noul」: https://docs.typesafe.ai/primitives/noul
- TypeSafe AI Docs「Confidence」: https://docs.typesafe.ai/confidence
- TypeSafe AI Docs「AI primer」: https://docs.typesafe.ai/introduction/machine-learning-primer
- TypeSafe AI Docs「Models」: https://docs.typesafe.ai/models
- TypeSafe AI Docs「Jev 1.13 jaggedness」: https://docs.typesafe.ai/model-jaggedness/jev-1.13
- TypeSafe AI Docs「Legal」: https://docs.typesafe.ai/legal