 ラピットくん
7月、ナレーションの声が決まらなかった
自社で作っている「historia-scape」という、写真を撮るとその場所の昔の風景をAIが描くアプリがあります。7月に、その紹介動画を作りました。60秒で、ナレーションは9本。合わせて52.4秒です。
声が、なかなか決まりませんでした。
最初は Google の Gemini に読ませるつもりで、スクリプトまで書いていました。ところが、APIキーが切れていた。Microsoft Edge の読み上げ機能をプログラムから借りる方法は、窓口が閉じていて使えない。仕方なく、Windows に最初から入っている「Ayumi」という声で仮に組みました。
最後は、ElevenLabs に用意してあった「ラピットくん」の声に差し替えています。うちのマスコットキャラクターです。
で、9月23日。Google が Gemini 3.8 Flash TTS という音声AIを出しました。
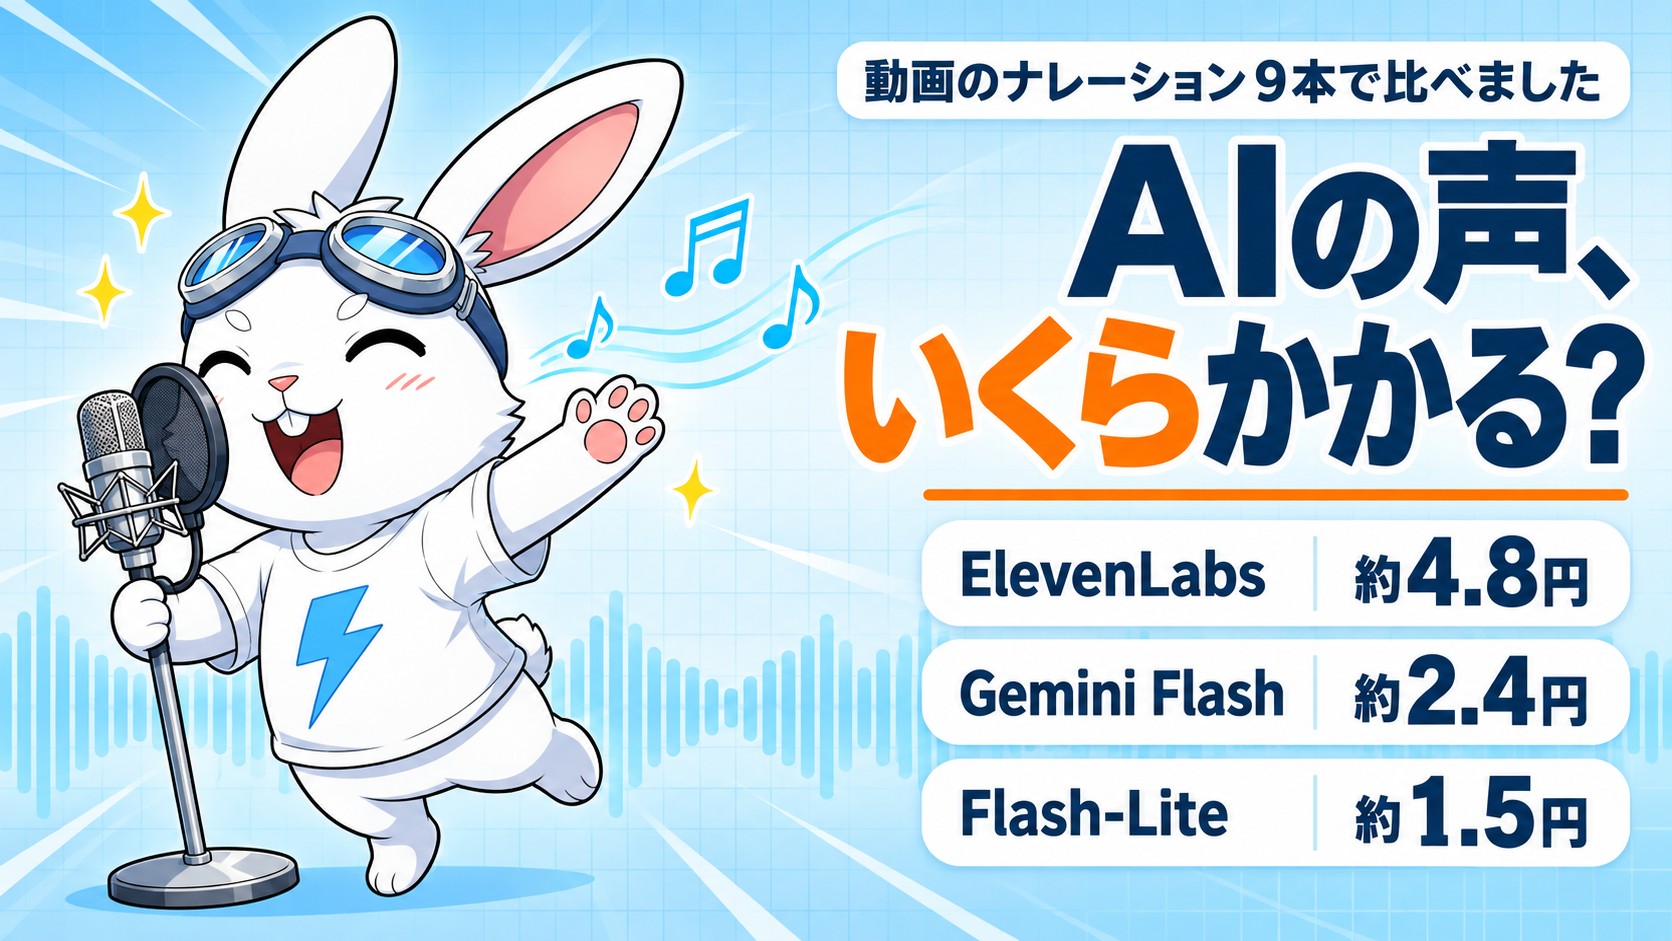
7月と同じ9本を読ませて、ElevenLabs と費用を比べてみました。
historia-scape は無料で配っています。どんなアプリかは、こちらに書きました。
▼関連記事
【自社事例】いまの景色を、江戸時代へ ― 時代風景カメラ「historia-scape」無料配布
そもそも、何が出たのか
TTS は Text-to-Speech の略で、文章を渡すと、読み上げた音声が返ってくる AI です。Gemini の TTS 自体は去年からありました。今回はその新しい世代で、2つのモデルが出ています。
| Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS | |
|---|---|---|
| 向き | 演技・キャラクター・長い朗読 | 大量に作る・安く作る・音声で応答するAI |
| 対応言語 | 130以上(日本語あり) | 100以上(日本語あり) |
| 料金(音声100万トークン) | $9(2027年から$18) | $6(2027年から$12) |
| 一般向けの提供先 | Gemini Notebook の音声解説 | Google Vids |
開発者向けには、どちらも Gemini API と Google AI Studio で使えます。AI Studio は、ブラウザで声を作って、その場で試聴できる画面になっています。
一般の人がいちばん触れやすいのは、Gemini Notebook の「音声解説」だと思います。7月に NotebookLM から名前が変わったものです。資料を入れると2人が掛け合いで解説してくれる、あの機能で、このモデルが使えるようになりました。日本も対象です。
新しくできるようになったことは、大きく3つです。
- 声を文章で作れる(声のデザイン)
- 30秒ほどの録音から、声を複製できる(本人の同意の録音が必須)
- 1行ずつ演技をつけられる(笑い、ため息、相づち、2人の掛け合い)
同じ9本で、ElevenLabsの約半分
先に結論から書きます。
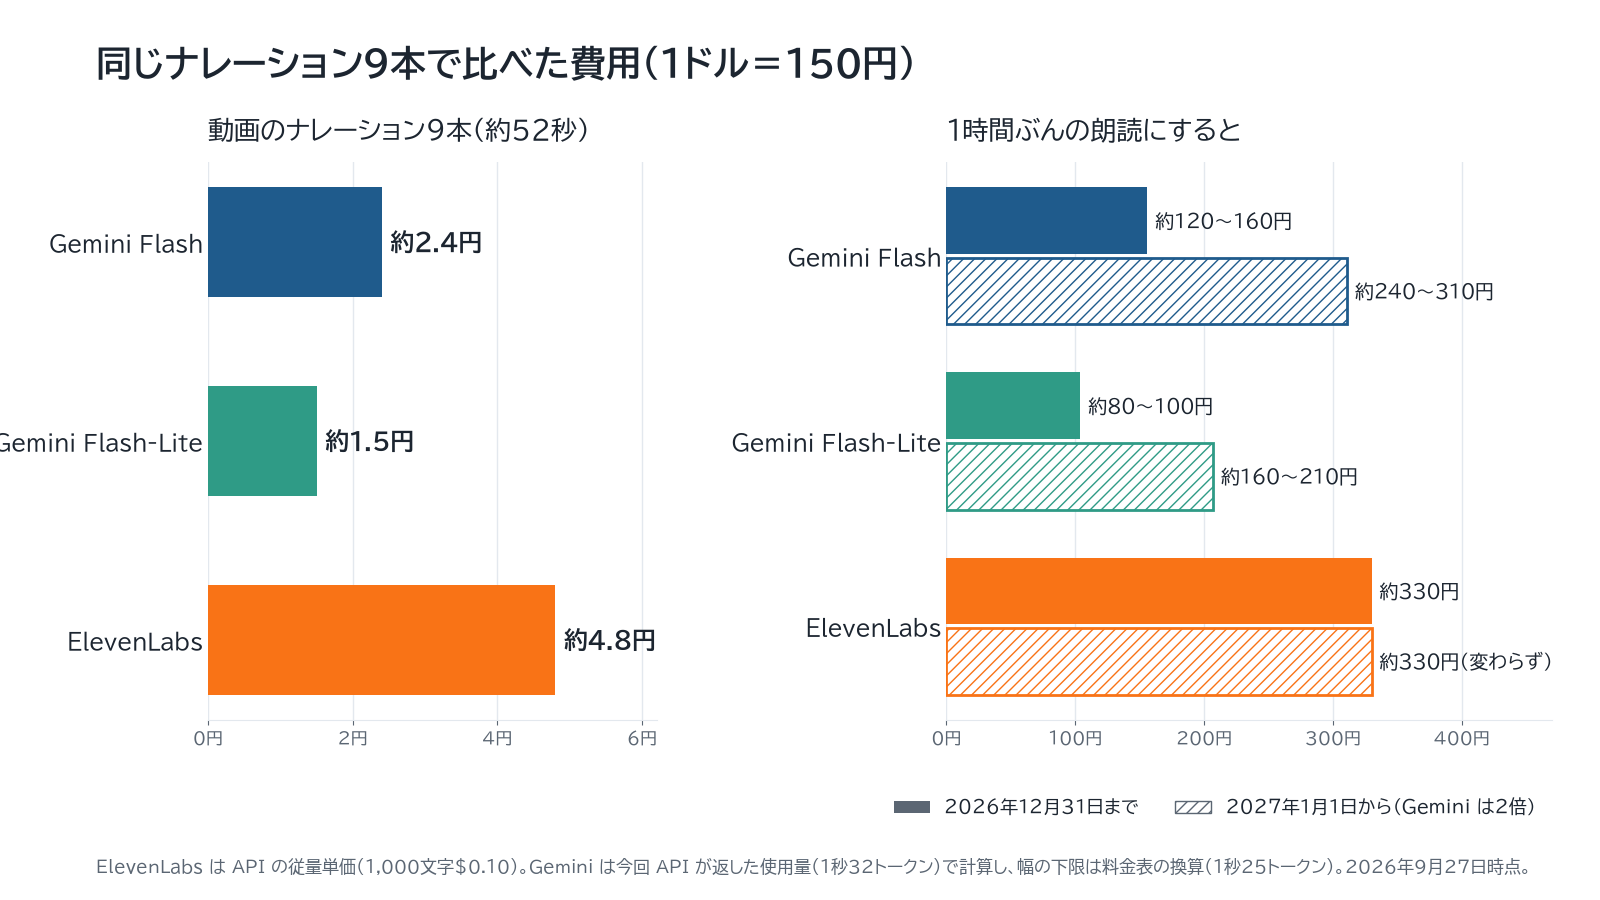
| 9本の長さ | 9本の費用 | 1時間あたり(年末まで) | 1時間あたり(2027年1月から) | |
|---|---|---|---|---|
| ElevenLabs(7月・Multilingual v2) | 52.4秒 | 約4.8円 | 約330円 | 約330円 |
| Gemini 3.8 Flash TTS | 55.5秒 | 約2.4円 | 約120〜160円 | 約240〜310円 |
| Gemini 3.8 Flash-Lite TTS | 53.0秒 | 約1.5円 | 約80〜100円 | 約160〜210円 |
1ドル=150円。ElevenLabs は API の従量単価(1,000文字$0.10)、Gemini は今回 API が返した使用量で計算。1時間あたりは、7月の台本と同じ話す速さ(1分366文字)で読み続けた場合
年末までなら、Flash で約半分、Flash-Lite で約3分の1です。
ただ、見てほしいのは右の列です。
Gemini は、2027年1月1日から全部2倍になります。 そうすると、Flash は1時間あたり約240〜310円。ElevenLabs の約330円と、ほとんど変わらなくなります。安さがはっきり残るのは、Flash-Lite のほうです。
数え方の違いも、書いておきます。
ElevenLabs は文字数で払います。今回の9本は320文字で、$0.032。Gemini は音声の長さで払います。1秒ごとにトークンを数えて、Flash なら100万トークンあたり $9。
なので、同じ台本でも、ゆっくり読む声ほど Gemini は高くなります。今回の9本は、7月の ElevenLabs 版が52.4秒、Flash が55.5秒、Flash-Lite が53.0秒。長さはほぼ同じだったので、比べやすい条件でした。うちの動画はナレーションの秒数から場面の長さを計算しているので、差し替えても、ズレを手で直す作業は出ません。
もうひとつ、数字が合わないところがありました。
料金表には「音声は1秒=25トークン」と書いてあります。でも、API が返してきた使用量は、23本ぜんぶ1秒あたり32トークンでした。表の「約120〜160円」の幅は、この違いです。安いほうが料金表の25、高いほうが使用量の32で計算した値。
実際の請求がどちらで来るかは、請求書が出てから確かめます。32のほうだと、年明けの Flash は ElevenLabs とほぼ並びます。
比べるときの前提も、はっきりさせておきます。
- ElevenLabs は月額プランの中で使うと、実質の単価はプランによって変わります(料金ページ)。ここでは、いちばん比べやすい API の従量単価を使いました
- Gemini には無料枠もあります。ただし無料枠で送った内容は、Google の製品改善に使われます(有料枠は使われない)。社外に出せない原稿なら、有料枠で
- 声のデザインで声を作るのにも、使用量から計算すると約1.6円かかりました。試し読みも全部入れた今回の費用は、約7円です
無料と有料でデータの扱いが変わる話は、先月、Claude を例にこちらで書きました。考え方は同じです。
▼関連記事
そのデータ、どこに何日残りますか? 「うちの顧客データを入れて、大丈夫なんですか?」
ほかに、使う前に知っておきたい数字が2つありました。
- 1回で作れる長さには上限がある。 出力の上限は16,384トークン。1秒32トークンなら約8分半です。「数時間の朗読」は、分けて作ってつなぐ前提になります
- 待ち時間は1本6秒ほど。 1本ずつ作り終わってから返ってくる形で、平均6.6秒(Flash)と6.1秒(Flash-Lite)。ナレーションなら9本で1分ほど。会話のように即答させたいなら、少しずつ流して返す方式(ストリーミング)を使うことになります
声は、文章で作れた。最初の注文は止められたけれど
7月の Gemini 用スクリプトでは、声を「Leda」にしていました。30種類ある既製の声のひとつで、説明には「Youthful(若々しい)」とあります。スクリプトには「代替: Puck(明るい)、Fenrir(興奮気味)」とメモも残っていました。
要するに、既製の声の中から、ラピットくんに一番近そうなのを選んでいたわけです。ぴったりの声は、そもそも無い。
3.8 では、ここが変わりました。声を、文章で注文できます。
文書のコツは、1〜2文で、具体的に。年齢や声質のような「変わらない性質」は声を作るときに決めて、場面ごとの演技は読ませるときに足す、という切り分けです。
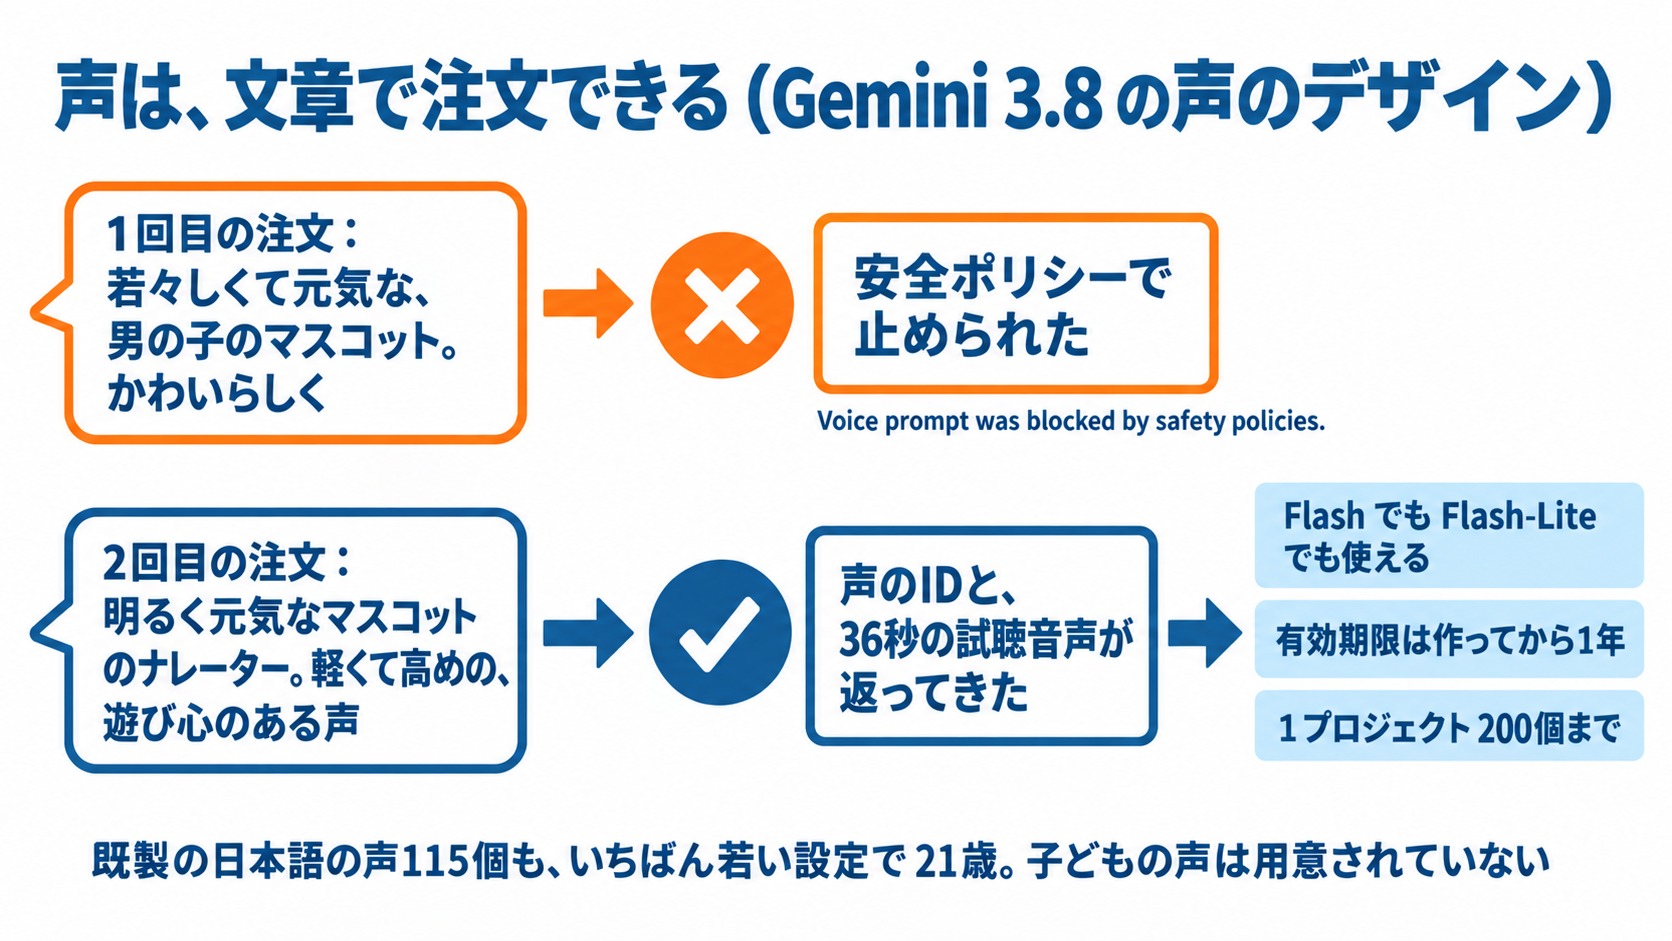
なので最初は、こう注文しました。「若々しくて元気な、男の子のマスコットキャラクター。明るく弾む声で、少し速め。かわいらしく、でも聞き取りやすく」(実際は英語で書いています)。
返ってきたのは、これでした。
Voice prompt was blocked by safety policies.
止められました。
どの言葉が引っかかったのかは、エラーからは分かりません。ただ、既製の声の一覧を見ると、日本語の115個は、いちばん若い設定でも21歳でした。子どもの声は、最初から用意されていないようです。
注文を変えました。「明るく元気なマスコットのナレーター。軽くて高めの、遊び心のある声」。男の子、若々しい、かわいい、を外して、キャラクターをナレーターと言い換えた形です。
今度は通りました。
声のIDと一緒に、36秒の試聴用の音声が返ってきます。文字起こしすると、「ピコピコフェスティバル」という架空のお祭りの告知でした。試聴の台本まで、向こうが勝手に書いていた。
ほかに分かったことを並べておきます。
- Flash で作った声は、Flash-Lite でもそのまま使えた
- 作った声には、ちょうど1年後の有効期限(2027年9月27日)が入っていた。保存できるのは1プロジェクト200個まで
長く使う声なら、作った日と、注文した文章と、試聴の音声を残しておいたほうがいいと思います。同じ文章で作り直しても、同じ声になるとは限りません。1年後に作り直すとき、元の声と聴き比べられるように。
既製の声の数も、数えてみました。全部で2,089個(19言語、地域別に数えると30種類)。公式ブログの「2,000以上」は本当で、API の文書にあった「数百」よりずっと多い。日本語は115個で、東京73・大阪22・福岡20。大阪や福岡のなまりの声もあります。
7月のスクリプトのまま送ったら、指示文まで読み上げた
ここは、作る側の人向けの話です。
7月のスクリプトは、台詞の前に、演技の指示を日本語でくっつけて送っていました。
元気いっぱいの子どもマスコットキャラクター「ラピットくん」として、
明るくワクワクした声で、少し速めのテンポで話してください。
かわいらしく、でも聞き取りやすく: ねぇねぇ、この景色…江戸時代になったら、どう見えると思う?
これまでの Gemini の TTS では、この書き方が普通でした。
3.8 は違います。文書に、本文は「一字一句そのまま読む台本」として扱うと書いてあります。演技の指示は、本文とは別の欄(speech_metadata の style)に分けて渡す。
本当にそうなるのか。7月のスクリプトと同じ形で、1本だけ送ってみました。声も7月と同じ Leda です。
台詞だけなら5秒ほどのところ、返ってきた音声は16.6秒ありました。手元の文字起こしにかけると、こう始まっていました。
元気いっぱいの子供マスコットキャラクターラピッド君として、明るくワクワクした声で少し早めのテンポで話してください。かわいらしく、でも聞き取りやすく。ねえねえ、この景色……
指示文を、全部読み上げていました。
実際の音声です。
しかも、長さで払うので、読み上げた指示文のぶんまで料金がかかります。この1本は、台詞だけのときの3倍以上でした。
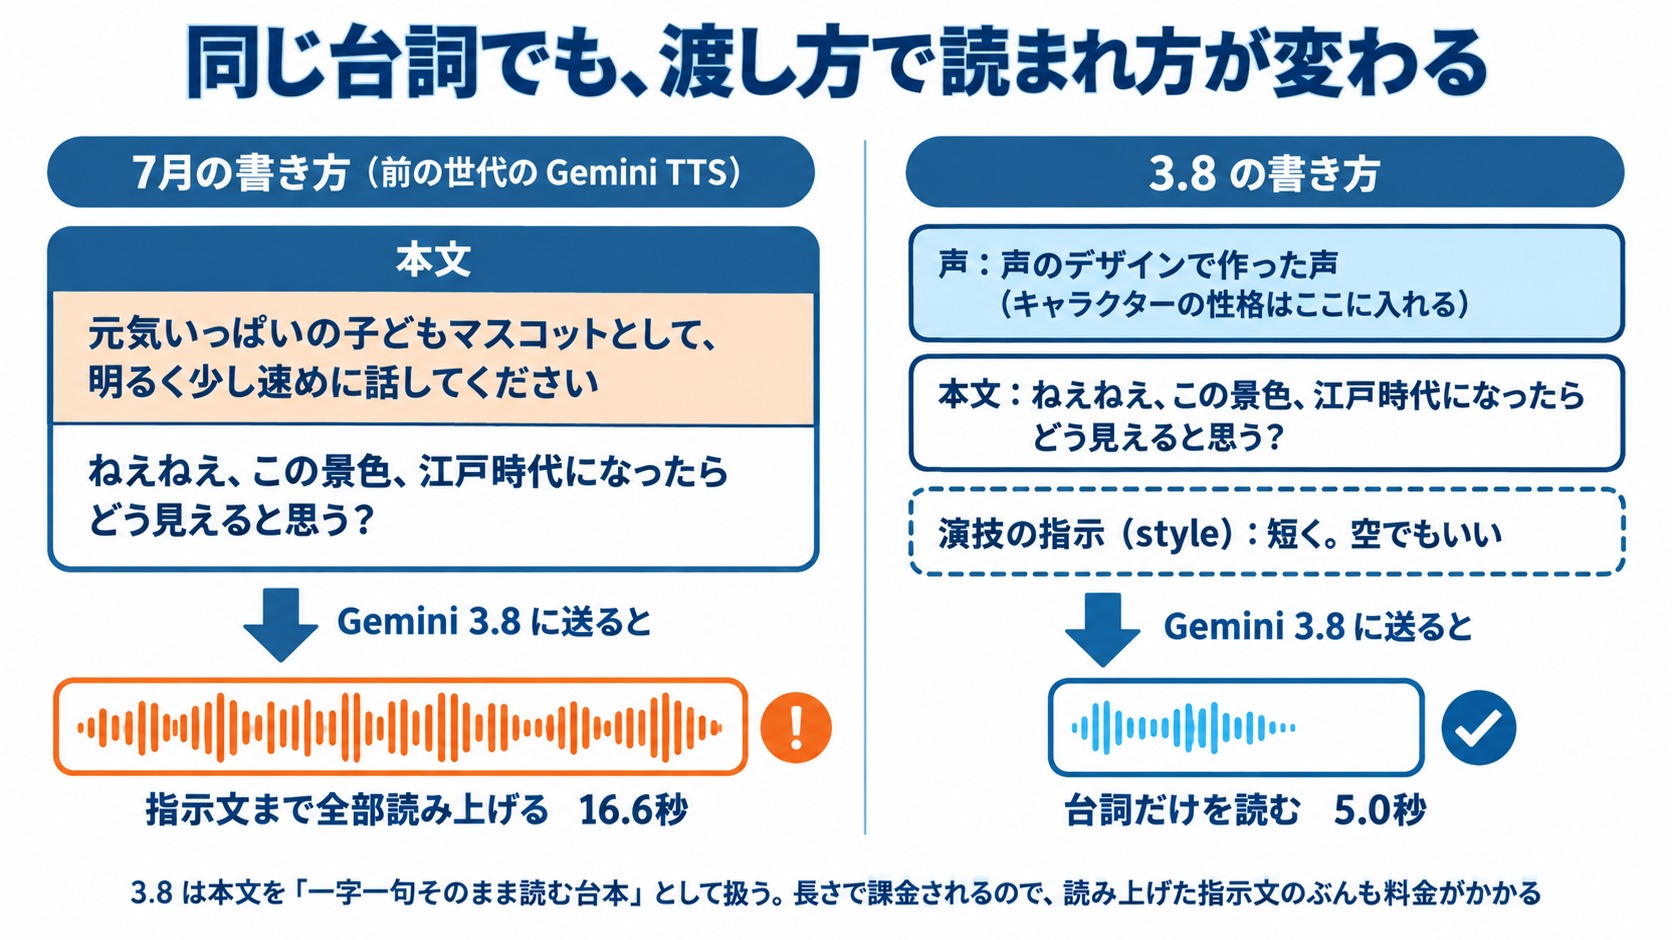
書き換えると、こうなります。
input: [{
  type: "user_input",
  content: [{
    type: "text",
    text: "じゃーん!たかまつのりつりんこうえんが、江戸時代の風景に!",
    // 演技の指示を足すなら、ここに短く
    // annotations: [{ type: "speech_metadata", style: "cheerful, a little fast" }],
  }],
}],
generation_config: { speech_config: [{ voice: "voice_..." }] }, // 作った声のID
今回の9本は、演技の指示を空にしています。
文書に「前の世代から持ち越した長い演技指示が、声がぶれるいちばんの原因」と書いてあったからです。キャラクターは先に声のデザインで作っておいて、読ませるときの指示は短く、なくてもいい。7月の僕のスクリプトは、台詞のたびに同じ指示文を送っていました。3.8 の考え方だと、これは声のほうに入れておく情報です。
ほかにも、変わったところが2つありました。
- 笑い声やため息は、本文に
<laugh><sigh>のように入れる。日本語の台本でも、タグは英語のままが推奨 - 返ってくる音声が、生のデータから WAV ファイルに変わった。7月のスクリプトは自分で WAV に包んでいたので、その処理は外す
地名の読みは、まだ台本で面倒を見る
7月の台本では、「高松の栗林公園」を読ませる用だけ「たかまつのりつりんこうえん」とひらがなで書いていました。
3.8 に漢字のまま渡すと、Flash は手元の文字起こしで「くりばり公園」。ひらがなに戻すと「りつりん」と読めました。
API の文書を読んだ範囲では、読み方を登録しておく辞書のような機能も見当たりません。固有名詞をひらがなで書き足す作業は、3.8 でも続きます。
「ベンチマーク1位」は、少し引いて読む
発表では、Hume AI という会社のベンチマークで、声のデザインが総合1位(71.4点)だったと書いています。日本語についても、ネイティブ話者が聴き比べる「Voice Arena」で上位に入ったそうです。
これを読むときに、知っておいていい事情があります。
Hume AI は、今年の1月に Google とライセンス契約を結んでいて、当時の CEO の Alan Cowen さんは Google DeepMind に移りました。今回の発表記事を書いた2人のうちの1人が、その Cowen さんです。
Hume 側もこの関係は開示していて、評価用のデータは開発チームに渡していない、と説明しています。なので、数字を疑えという話ではありません。実際、Hume の結果を細かく見ると、「若い大人の声の正確さ」は ElevenLabs v3 のほうが上(68.1% 対 34.0%)、という項目もちゃんと載っています。
ただ、どのランキングも「うちの台本」で測ったものではない。
動画生成AIを値段で比べたときも、結論は同じでした。ランキングで絞って、最後は自分の素材で決める。
▼関連記事
AI動画生成、いまどれを使う? Veo・Seedance・Klingなど12モデルを「使える2秒」の値段で比べました【2026年9月版】
30秒で声が複製できる。だから同意の録音が要る
声の複製は、今回は試していません。ただ、いちばん気をつけたい機能なので、仕組みだけ書いておきます。
複製したい人の声を10〜30秒録る。それとは別に、同じ人が決められた一文を読み上げた録音を出す。日本語だと、この文です。
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。
2つの録音が同じ人の声か、システムが照合します。どこかの動画から声を抜き出しただけでは、作れないようになっている。生成した音声には、耳では聞こえない電子透かし(SynthID)も入ります。AI Studio での声の複製は、米国の一部の州や欧州などでは使えませんが、日本は使えます。
もし社員の声で、研修の動画や電話の案内を作るなら。同意の録音を誰がどこに保管するか、その人が辞めたら声をどうするか。ここは、技術より先に決めておいたほうがいいと思います。
で、どれを使うか
費用だけなら、答えははっきりしています。年末までは Gemini、とくに Flash-Lite が安い。年が明けると、Flash と ElevenLabs の差はほとんど無くなります。
なので、決め手は声のほうです。
同じ1本(「ねえねえ、この景色…江戸時代になったら、どう見えると思う?」)を、3つで読ませた音声を置いておきます。Gemini の2つは、声のデザインで作った同じ声で、演技の指示は空です。
3つを聴き比べて、いちばんラピットくんに聞こえたのは Gemini Flash でした。
7月は、Gemini の既製の声にぴったりのものがありませんでした。それが、文章で注文しただけで、ElevenLabs より近くなった。しかも年末までは費用が約半分です。次に作り直すなら、Flash を使います。
年が明けて値段が2倍になっても、ElevenLabs とほぼ同じ。声で選んで、費用で負けない。いまの判断はここです。
ちなみに、手元の文字起こしAIにかけると、Flash は9本とも台本どおりに起こせました。Flash-Lite は2本で小さなずれ。7月の ElevenLabs 版は、9本中4本で聞き取り違いが出ています(「江戸時代」が「丁度時代」、「昔」が「咳」など)。キャラクターの演技が強いほど機械には聞き取りにくいので、これは良し悪しの話ではありません。
試し録りはスクリプトで回せても、「これはラピットくんだ」と決めるのは耳です。会社紹介ムービーを作ったときも、最後に耳で聴いて決めたのは僕でした。
▼関連記事
編集ソフトを開かずに、15秒の会社紹介ムービーができた ― 動画を「計算」で作る仕組み
「研修の動画に声を入れたい」「案内の音声をAIで作りたい」といった相談も受け付けています。どの声で、どこまでAIに任せるか。動くものを先に見せるところから、一緒にやります。
10月9日には、福岡の大名カンファレンスで登壇します。
▼関連リンク
『30分無料プロトタイプ提案』の相談
手を動かして学ぶ DX-NoCodeBootCamp®
福岡・大名カンファレンスに弊社代表 宮崎翼が登壇します
まとめ
- Gemini 3.8 Flash TTS/Flash-Lite TTS は、2026年9月23日に Google が出した音声AI。どちらも日本語に対応している
- 動画のナレーション9本(約52秒)を同じ台本で作ると、ElevenLabs 約4.8円に対して、Flash 約2.4円、Flash-Lite 約1.5円
- ただし Gemini は2027年1月から2倍。1時間あたりで見ると、Flash は ElevenLabs とほぼ同じになる。安さが残るのは Flash-Lite
- ElevenLabs は文字数、Gemini は音声の長さで払う。API が返す使用量は1秒32トークンで、料金表の25と合わない。請求で確かめる
- 声は文章で作れる。ただし「若々しい男の子」のような注文は安全ポリシーで止められた。作った声は1年で期限が切れる
- 3.8 は本文を「一字一句の台本」として読む。7月のスクリプトのまま送ったら、演技の指示文まで読み上げて、そのぶんも課金された
- 聴き比べて、いちばんラピットくんに聞こえたのは Gemini Flash。声で選んで、費用でも負けない
- ランキングは自分の台本で測ったものではない。最後は自分の台本で試して、耳で決める
本記事の内容は2026年9月27日時点のものです。料金は各社の公式ページ(Gemini API は2026年末までの価格)で計算しています。使う前に確認してください。
参考: