 ラピットくん
表では同じ速さなのに、「遅い」と言われています
9月版のベンチマーク記事で、速さの表を載せました。
Claude Fable 5.1 が67 tok/s、GPT-6 Astra が63 tok/s。ほぼ同じです。
で、今日、聞いたのがこれです。
「でも、Claude Code って遅くないですか」
正直、分かります。長めの作業を頼むと、けっこう待つ。コーヒーを淹れて戻ってきても、まだ動いていたりする。
表の上では同じなのに、使っていると遅く感じる。どっちを信じればいいのか。
これ、どっちも本当になりえます。表の tok/s と、体感の「遅い」は、測っているものが違うからです。
「速さ」には、2種類あります
表に載っている tok/s は、モデルが1秒あたりに何トークン書けるかです。手を動かす速さ、みたいなものです。
一方で、僕らが「遅い」と感じるのは、頼んでから終わるまでの時間です。
Claude Code に「このバグを直して」と頼むと、1回の応答では終わりません。ファイルを読む。直す。テストを書く。テストを実行する。結果を見て、また直す。この1歩ごとに、モデルが考えて、応答を書いています。
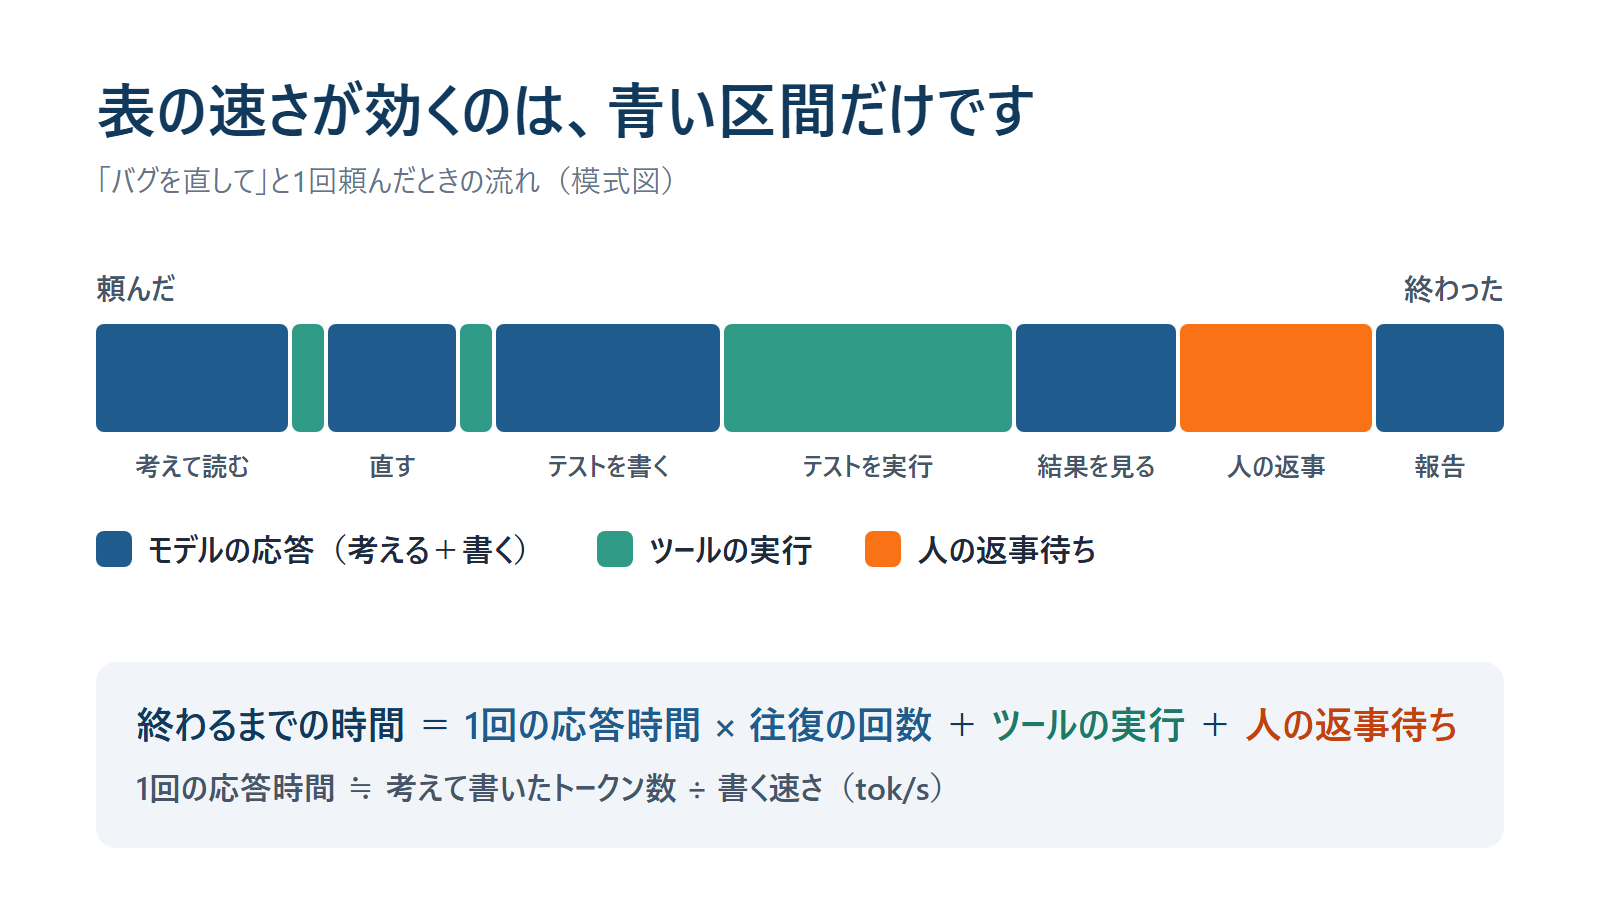
式にすると、こうです。
終わるまでの時間 = 1回の応答時間 × 往復の回数 + ツールの実行 + 人の返事待ち
そして、1回の応答時間は「考えて書いたトークン数 ÷ 書く速さ」でほぼ決まります。
表の tok/s が効くのは、この中の「書く速さ」の1か所だけ。なので「遅い」の原因の候補は、ほかにもいくつもあります。
| 候補 | 何を見れば分かるか |
|---|---|
| モデルの書く速さが遅い | 1秒あたりに書いたトークン数 |
| 考える量・書く量が多い | 思考トークン・出力トークン |
| 往復の回数が多い | 1回の指示で、モデルが何回応答したか |
| コマンドの実行が長い | テストやビルドの結果が返ってくるまでの時間 |
| 人の返事待ち・承認待ち | 質問や確認ダイアログで止まっていた時間 |
どれが効いているかで、打つ手がまるで変わります。書く速さが原因なら、道具を替えるしかありません。でも往復が原因なら、頼み方で縮むかもしれない。
じゃあ、僕の場合はどれなのか。
自分のログを、時刻だけで分けてみました
Claude Code は、会話の記録を自分のPCにファイルで残しています。前にモデルの切り替えを調べたときにも使ったログです。
ただ、このログには「何秒かかったか」の欄がありません。
そのかわり、記録の1つ1つに時刻が付いています。なので、差を取りました。
- モデルの応答:指示やツールの結果が届いた時刻から、モデルが応答を書き終えた時刻まで
- ツールの実行:モデルが「このコマンドを実行して」と書き終えた時刻から、結果が返ってきた時刻まで
会話の中身は読んでいません。見たのは、時刻とトークン数とツールの名前だけです。
対象は2026年9月3日〜16日の14日間。僕が出した指示が1,798回、モデルの応答が25,668回。Claude Code が動いていた時間を足すと、154時間ありました。指示と指示の間の、僕が席を外していた時間は入れていません。
ログを開いて自分の作業を数えるのは、これが2回目です。1回目は、切り替えないと決めたモデルを翌日に切り替えていた話でした。
▼関連記事
最新モデル、いつ現場で使う? リリースが自分の画面に降りてくる順番
書く速さは、表のとおりでした
まず、いちばん気になっていたところから。
Claude Code の中で、モデルは本当に遅くなっているのか。出力が1,000トークン以上ある応答だけを取り出して、1秒あたりに書いたトークン数を出しました。
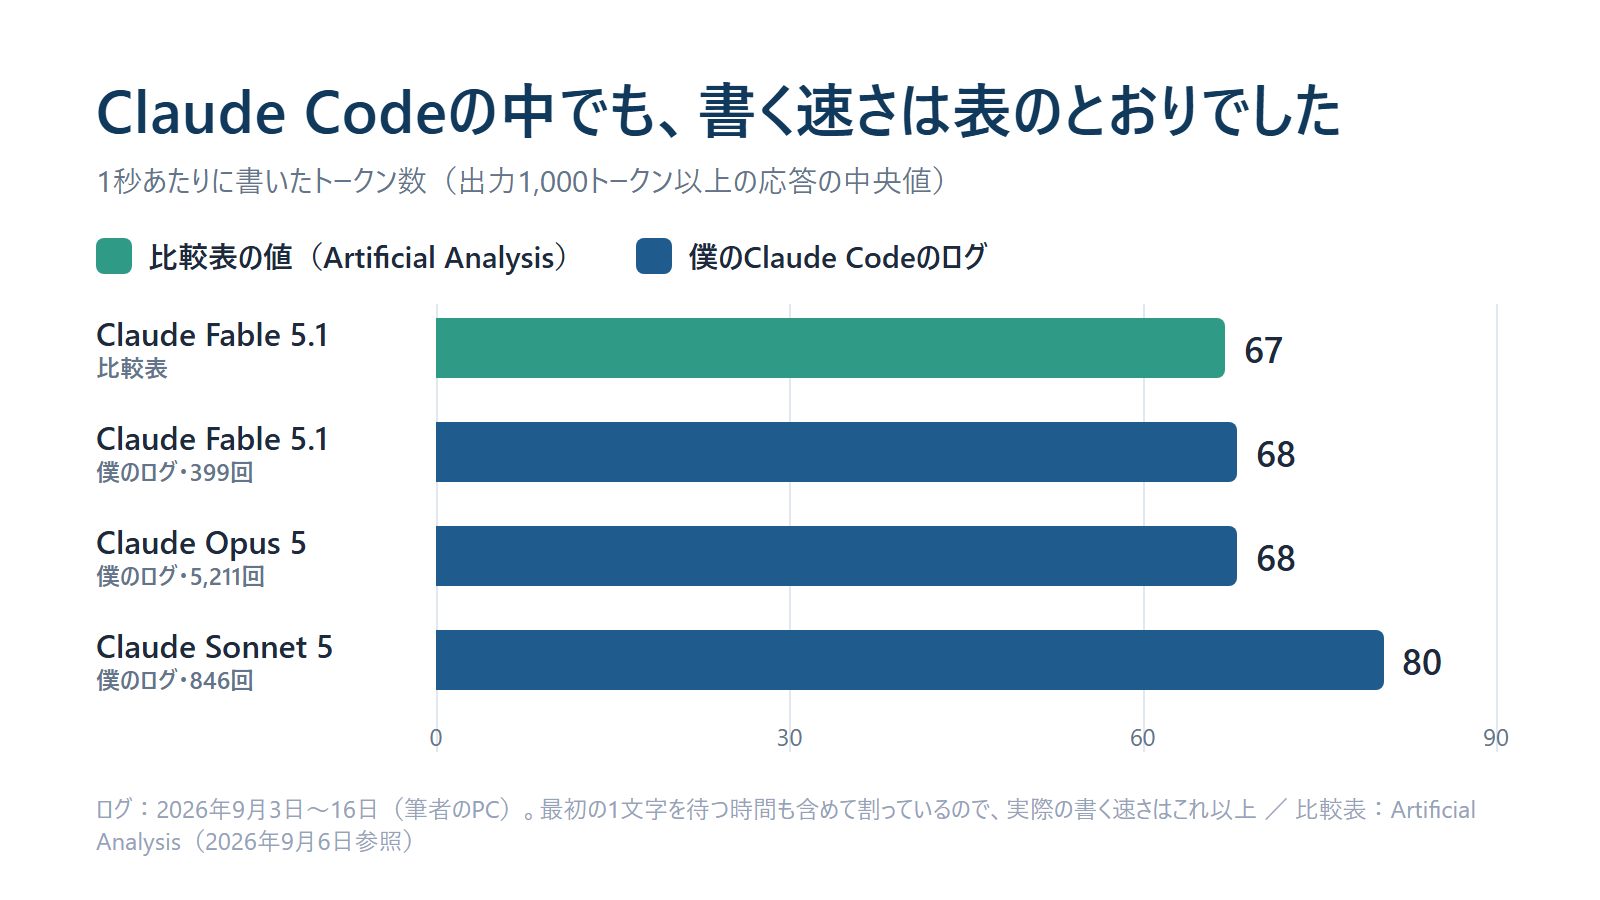
Fable 5.1 は68 tok/s。 表の67 tok/s と、ほとんど同じです。主力で使っている Opus 5 も68 tok/s、Sonnet 5 は80 tok/s でした。
しかもこの数字は、最初の1文字が出てくるまでの待ち時間も含めて割っています。純粋に書いている間の速さは、これより上のはずです。
時間帯でも分けました。Opus 5 で、いちばん遅かった16時台が63 tok/s、いちばん速かった20時台が71 tok/s。混む時間に目に見えて遅くなる、ということもありませんでした。
Claude Code を通すとモデルが遅くなる、というのは、僕のログでは違いました。
じゃあ、あの待ち時間は何だったのか。
154時間のうち、3分の2はモデルの応答でした
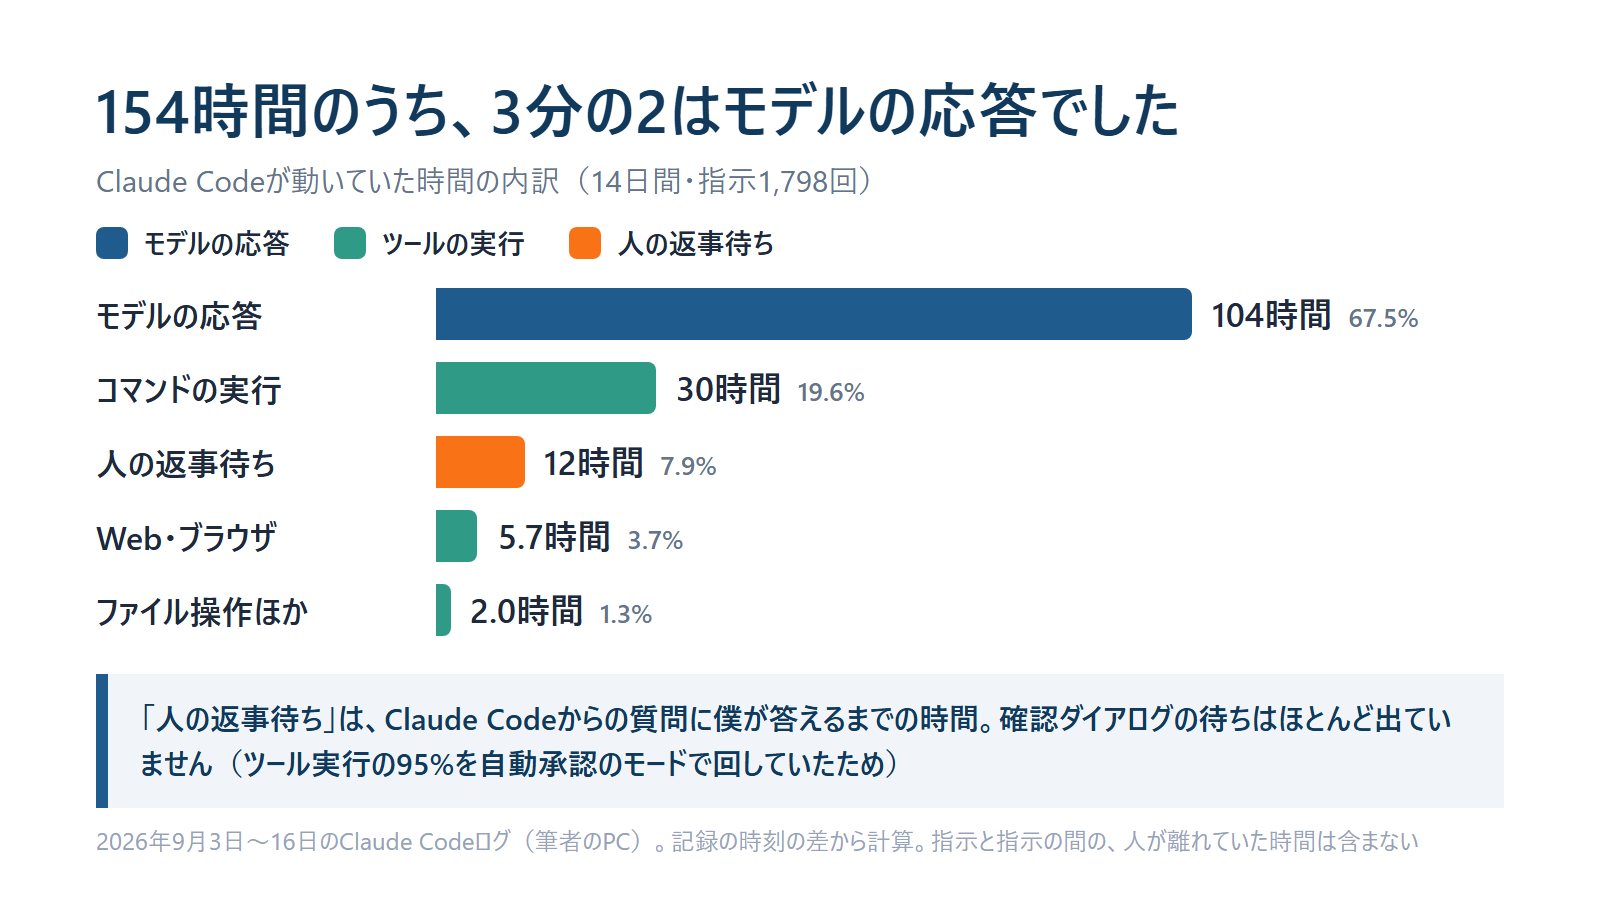
内訳はこうです。
| 区間 | 時間 | 割合 |
|---|---|---|
| モデルの応答 | 104時間 | 67.5% |
| コマンドの実行 | 30時間 | 19.6% |
| 人の返事待ち | 12時間 | 7.9% |
| Web・ブラウザ | 5.7時間 | 3.7% |
| ファイル操作ほか | 2.0時間 | 1.3% |
いちばん大きいのは、やっぱりモデルの応答でした。 書く速さは表どおりなのに、時間の3分の2はここです。
コマンドの実行は30時間。1回で1分を超えたコマンドは303回あって、この303回だけで15時間でした。ここはモデルではなく、PCの側の処理を待っている時間です。モデルを速いものに替えても、ここは縮みません。
人の返事待ちは12時間。Claude Code から「どちらにしますか?」と聞かれて、僕が答えるまでの時間です。141回あって、中央値は2分11秒。
僕のほうも、けっこう待たせていました。
ちなみに、確認ダイアログの「実行していいですか?」で止まっていた時間は、ほとんど出てきませんでした。ツールの実行の95%を、auto モード(許可するかどうかを自動で判定するモード)で回していたからです。毎回手で許可している人は、ここが大きく出るはずです。
承認待ちで止まったまま気づかない、というのは僕も困っていて、見張り役を作ろうとしたことがあります。
▼関連記事
Herdrで「承認待ち」の見張り役を自作したら、標準機能にありました
時間がかかった指示は、往復が多い指示でした
書く速さは同じなのに、なぜモデルの応答に104時間もかかったのか。
指示1回ごとに束ねてみました。ここでは人の返事待ちを除いて、機械が動いていた時間だけで見ています。
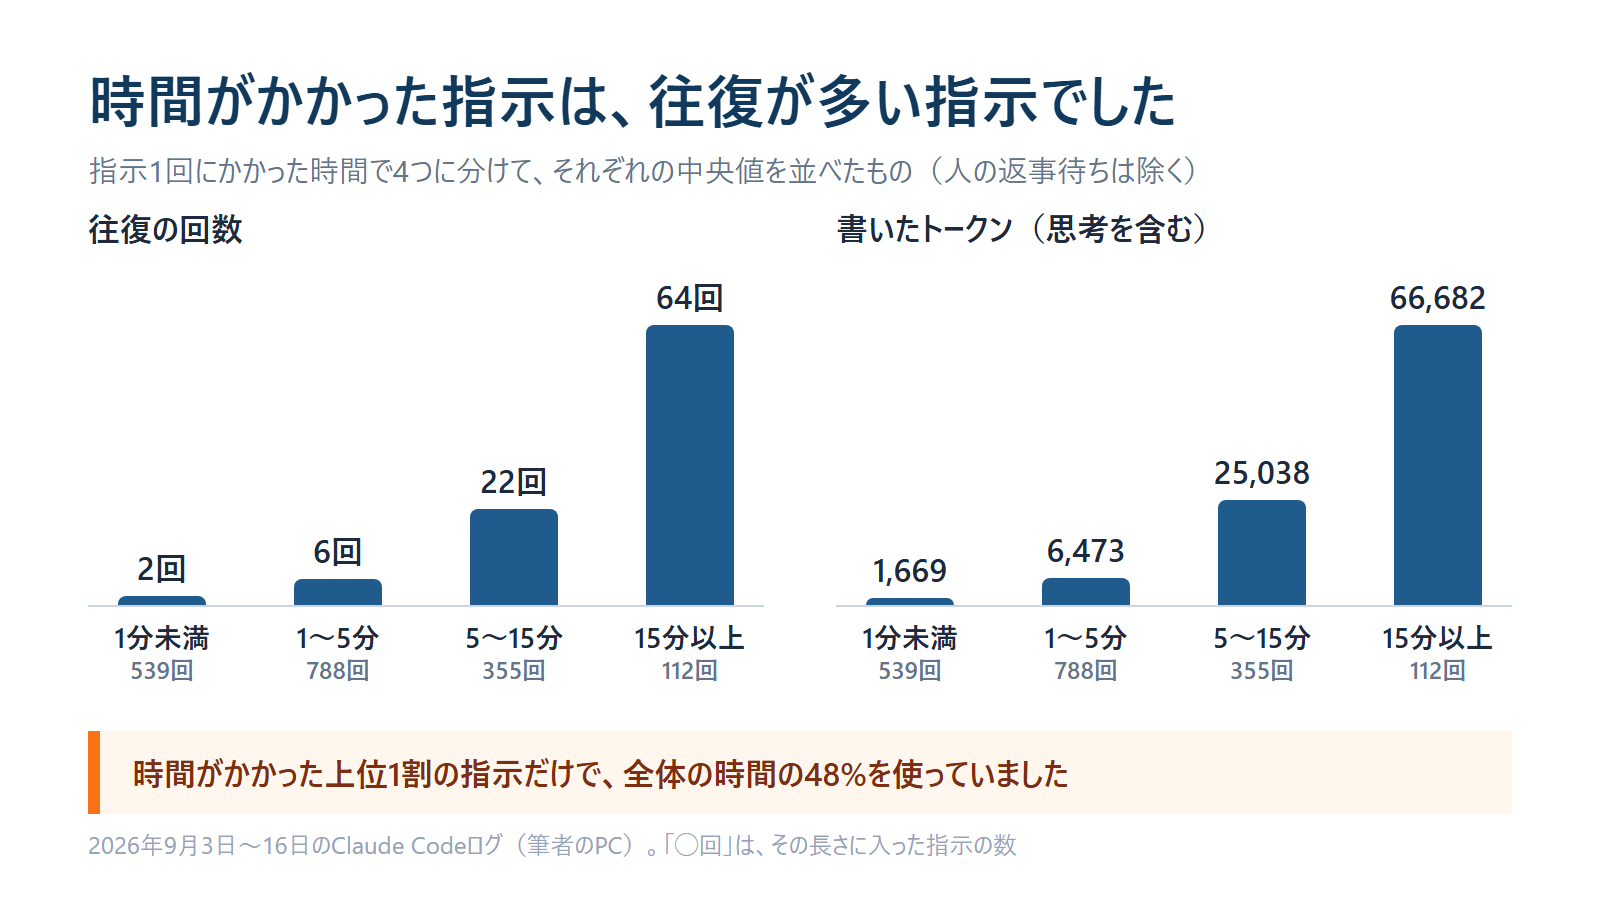
| 指示1回の時間 | 指示の数 | 往復の回数(中央値) | 書いたトークン(中央値) |
|---|---|---|---|
| 1分未満 | 539回 | 2回 | 1,669 |
| 1〜5分 | 788回 | 6回 | 6,473 |
| 5〜15分 | 355回 | 22回 | 25,038 |
| 15分以上 | 112回 | 64回 | 66,682 |
きれいに増えています。 1分で終わる指示は2往復。15分以上かかった指示は64往復。
しかも、時間がかかった上位1割の指示だけで、全体の時間の48%を使っていました。指示1回の中央値は2.1分なので、普段はそこまで待っていないんです。ときどき来る長い指示が、「遅い」の印象を作っているんだと思います。
1回の応答で見ても、同じでした。Opus 5 で1,000トークン以上書いた応答は、全体の27%。でも、応答にかかった時間の66%は、この27%が使っています。
要するに、時間を決めていたのは「書く速さ」ではなく「書いた量」と「往復の回数」でした。速さが同じなら、書いた量と往復が多いほうが遅い。当たり前といえば当たり前です。
ただ、往復が多いのは悪いことばかりではありません。テストを回して、落ちたら直して、もう一度回す。これも往復です。速く終わって間違っているより、確かめてから終わってくれるほうが、結局は早いことも多いです。
effort を上げると、1回の応答が長くなっていました
もう1つ、考える深さ(effort)でも分けてみました。Opus 5 の場合です。
| effort | 応答の回数 | 1回の時間(中央値) | 書いたトークン(平均) | うち思考 |
|---|---|---|---|---|
| high | 13,536回 | 7.3秒 | 898 | 330 |
| xhigh | 5,296回 | 9.5秒 | 1,096 | 461 |
| max | 588回 | 11.1秒 | 1,342 | 601 |
effort を上げるほど、よく考えて、1回の応答が長くなっています。
ただ、これは厳密な比較ではありません。難しい作業のときほど、僕が effort を上げているからです。作業の中身が違うので、「max にしたから遅くなった」とまでは、このログでは言えません。
それと、前の記事で「effort を下げればコストが下がる、と言っている本人が下げていなかった」と書きました。今回の14日間も、Opus 5 で low と medium は0回。
相変わらずでした。
ここで、ひとつ推測を立てました
書く速さは表のとおりで、時間を使っていたのは量でした。
で、ここで9月版の記事を思い出しました。GPT-6 Astra は、コーディングで前世代のモデルの3分の1のトークンしか使っていない、と書いた件です。
書く速さがほぼ同じなら、少ないトークンと少ない往復で終わるほうが、先に終わるはずです。「Claude Code は遅い」の正体は、ここなんじゃないか。
最初は、この推測を書いて記事を終えるつもりでした。
でも、推測は推測です。Codex のログも僕のPCに残っていましたが、9月分で Astra が実際に作業をしたのは47ターンだけ。しかも別々の仕事の記録なので、並べても比べられません。
なので、同じ課題をやらせてみました。
Claude Code と Codex に、同じ課題を5回ずつ
用意したのは、請求書をつくる小さなプログラムです。Node.js で、ファイルが5つ、テストが13本。ここに3つの課題を出しました。
| 課題 | 頼んだこと |
|---|---|
| 小さな修正 | 請求書の日付を「2026/09/17」から「2026年9月17日」の表記に変える |
| バグ修正 | 月末締めのお客さんで、2月の請求期間が「3月4日〜3月3日」になるのを直す |
| 機能追加 | 明細をCSVで出す関数を足す(カンマや改行を含む品名の扱い、BOM付き) |
条件は、こうそろえました。
- モデルは、Claude Code が Claude Fable 5.1、Codex が GPT-6 Astra。考える深さ(effort)は、どちらも high
- 毎回、まっさらな同じ状態から始める
- 確認ダイアログで止まらない設定にして、使い捨てのフォルダで回す
- Claude Code と Codex を交互に回し、先に回すほうも入れ替える
- キャッシュが温まっていない最初の1回は、試運転として数えない
合否は、エージェントに見せていないテストで決めました。課題の仕様どおりに動くかを確かめるテストを別の場所に書いておいて、終わったあとで流します。プロジェクト自身のテストも通って、はじめて合格です。「終わりました」と言っても、テストが落ちたら不合格。
時間は、頼んでから終わるまでを外から測りました。内訳は、Claude Code は画面を開かずに実行したときの結果に入る値(duration_ms と duration_api_ms)から、Codex はcodex exec で実行したあとのセッションのログの時刻から出しています。
計測したのは2026年9月17日、僕の Windows 11 のPCです。
トークンを2倍書いたほうが、先に終わりました
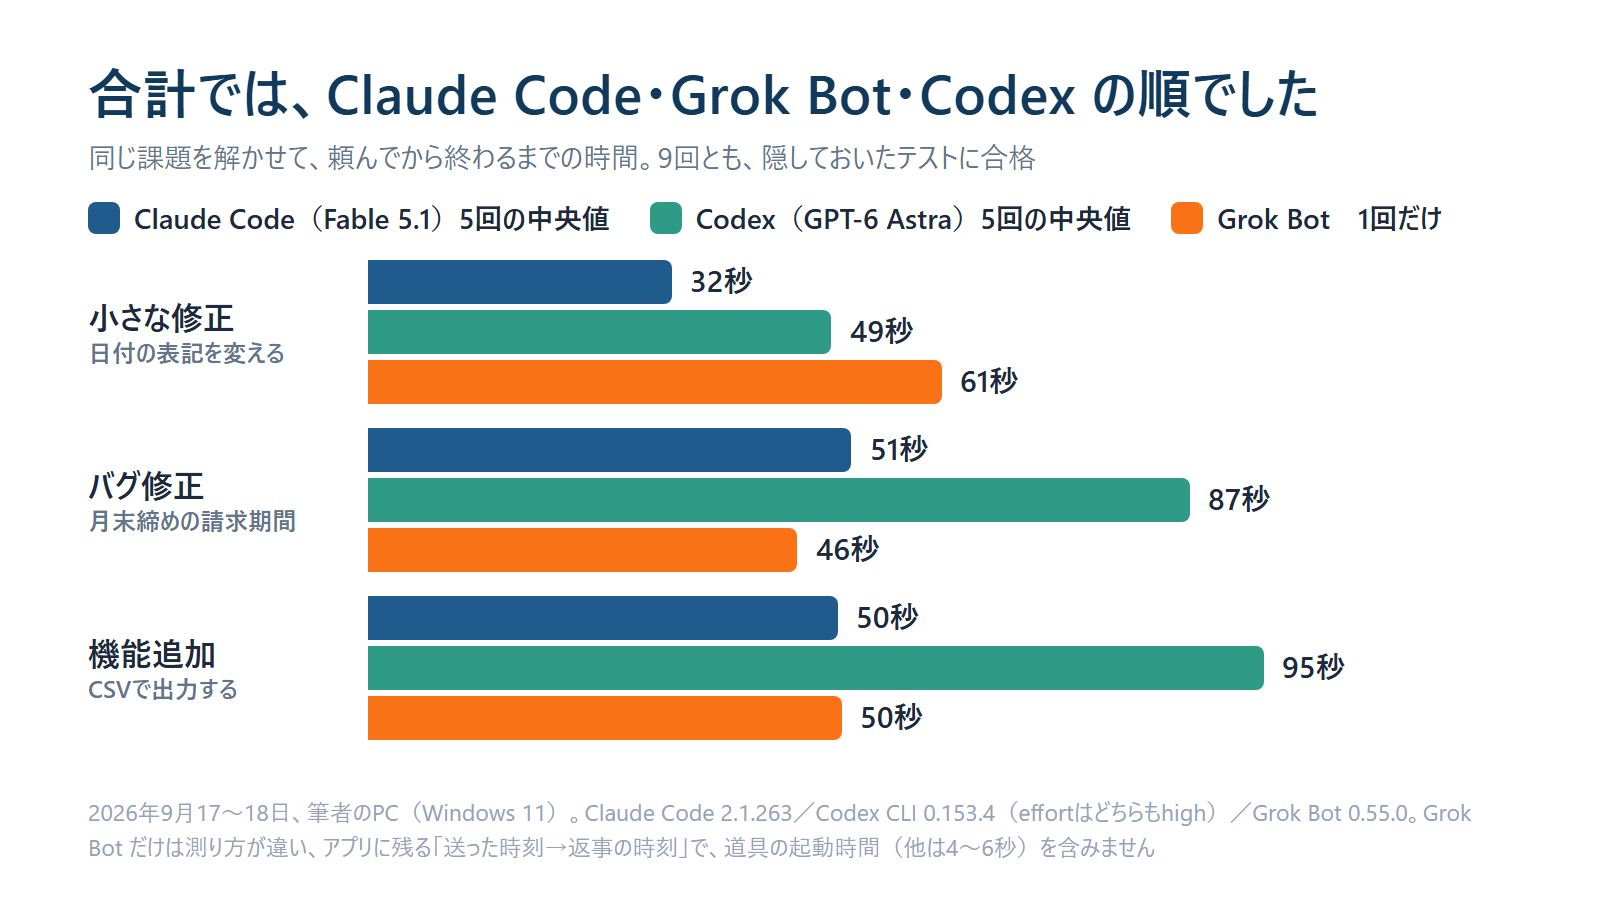
| 課題 | Claude Code | Codex |
|---|---|---|
| 小さな修正 | 32秒 | 49秒 |
| バグ修正 | 51秒 | 87秒 |
| 機能追加 | 50秒 | 95秒 |
5回の中央値です。合格は、どちらも3課題とも5回中5回でした。
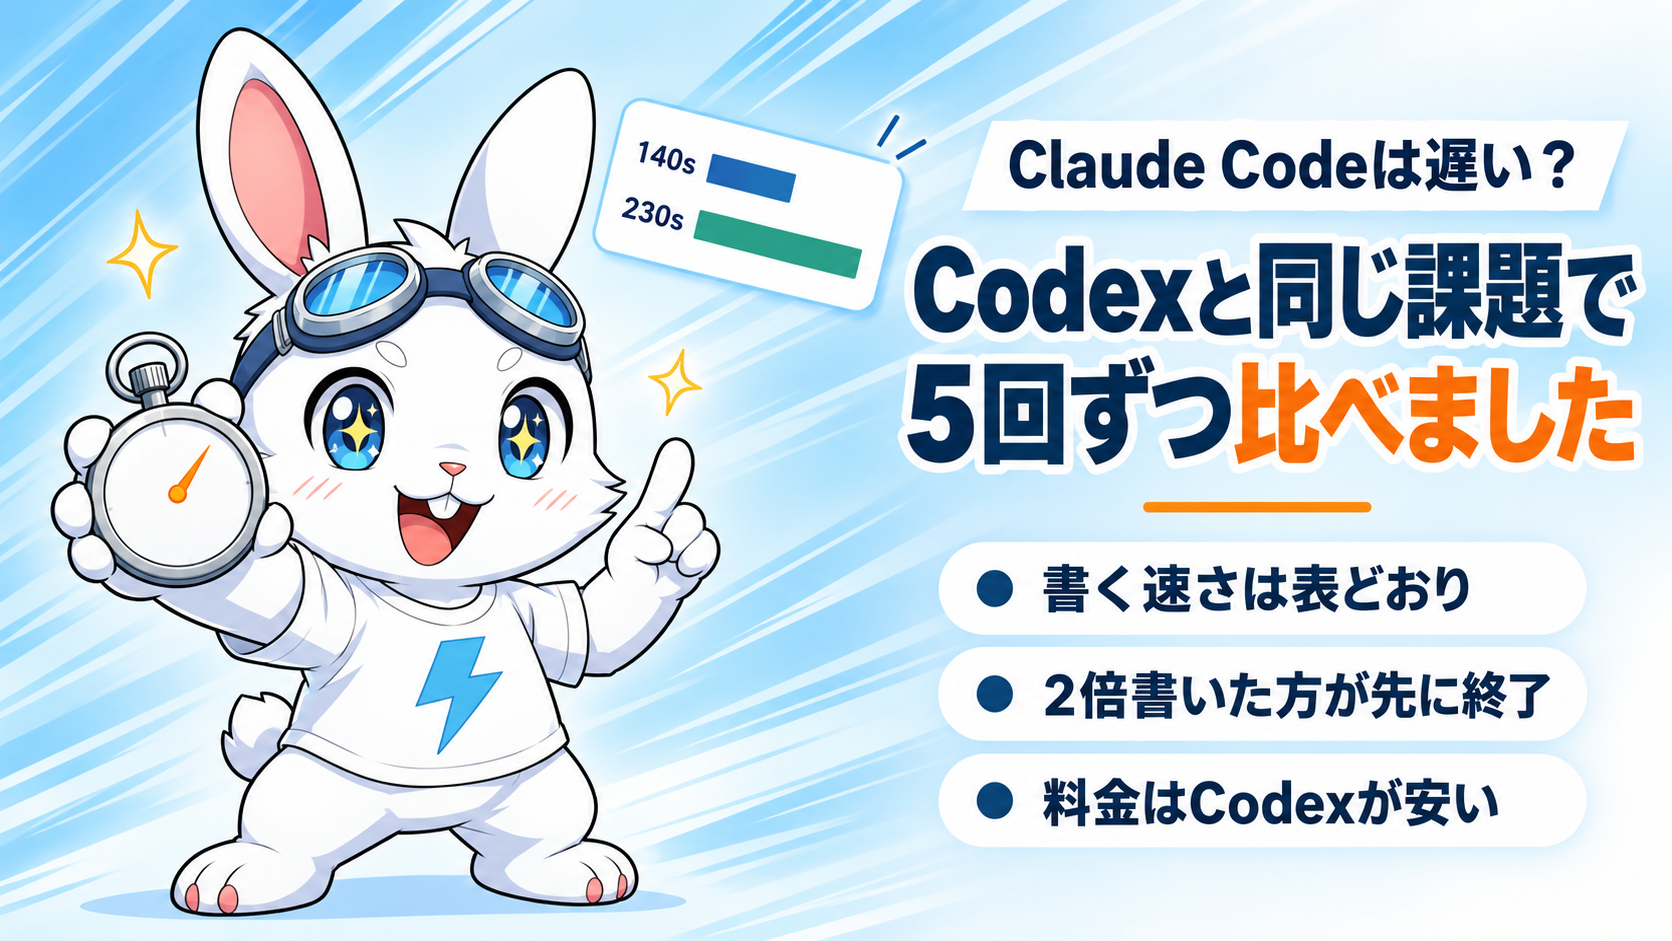
3つとも、Claude Code のほうが先に終わりました。 3課題を足すと、Claude Code が140秒、Codex が230秒(5回の平均)。Codex のほうが約1.6倍かかっています。
で、ここからが予想と違ったところです。
書いたトークンは、Claude Code のほうが約2倍多かったんです。3課題の合計で、Claude Code が9,074、Codex が4,455。
推測どおりなら、少なく書いた Codex が先に終わるはずでした。逆でした。
僕の推測は、この条件では外れました。
Codex は、応答にもコマンドにも時間がかかっていました
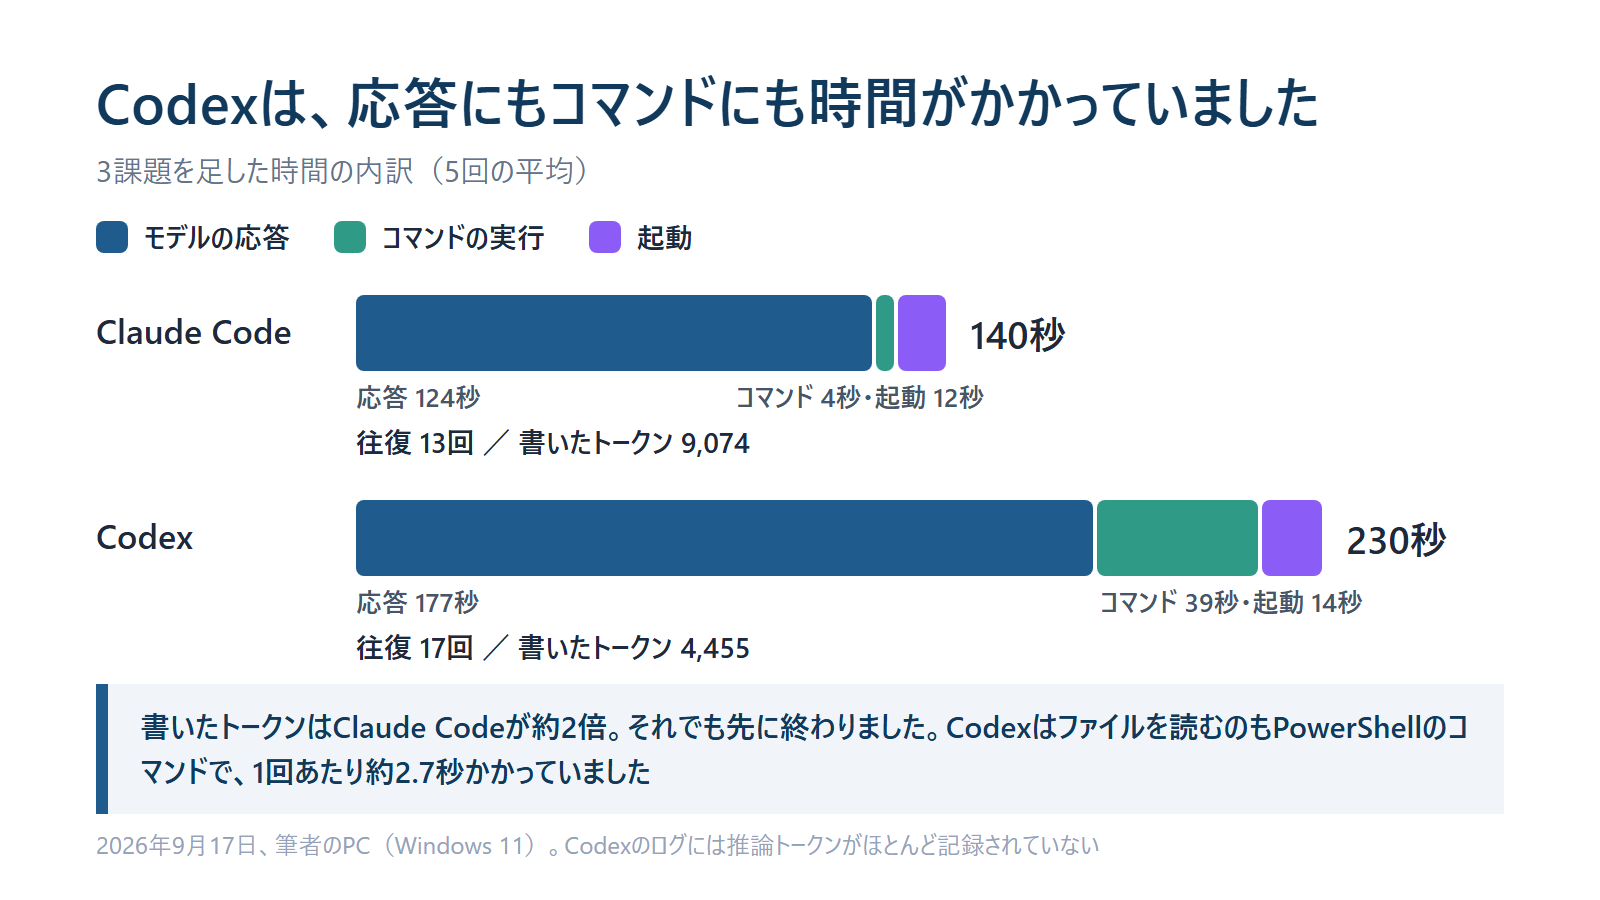
内訳を見ると、差は2か所で出ていました。
1つ目は、コマンドの実行です。 3課題で、Codex が39秒、Claude Code が4秒。
記録を見て、理由が分かりました。Codex は、ファイルの中身を読むのも PowerShell のコマンドでやっていたんです。本番の15回で82回のコマンドを実行していて、すべて PowerShell を立ち上げていました。1回あたり、約2.7秒。
Claude Code には、ファイルを読む・書くための専用の道具があるので、そのたびにコマンドを立ち上げずに済みます。Windows だと、この差がそのまま出ました。Mac や Linux ではコマンドの立ち上げがもっと軽いので、差は縮むと思います。
2つ目は、モデルの応答そのものです。 3課題で、Codex が177秒、Claude Code が124秒。
往復は Codex のほうが多く、17回と13回。応答1回にかかる時間は、どちらも10秒前後でほとんど同じでした。なのに Claude Code は、その10秒で2倍のトークンを書いています。
Codex は、作業を始めてから最初の1トークンが出るまで、約4.5秒かかっていました。試運転の記録を見ると、数十トークンしか書かない短い応答でも、1回に3〜5秒。1回ごとの待ちが重いようです。
ただ、Codex のログには、考えた量(推論トークン)がほとんど記録されていませんでした。見えないところで考えていた分があるなら、書いた量の差は、もっと小さいかもしれません。
料金は、Codex のほうが安かった
速さだけ書くのは不公平なので、料金も出しておきます。公開単価で計算した目安です。
| Claude Code | Codex | |
|---|---|---|
| 課題1回あたりの料金(平均) | $0.55 | $0.35 |
Claude Code の $0.55 のうち、$0.37 はキャッシュへの書き込みでした。作業を始めるたびに、システムの指示や道具の説明を2万トークン近くキャッシュに書き込んでいて、その割増が効いています。
9月版の記事では、「キャッシュの読み取りが4分の1だから、長い作業では Fable 5.1 のほうが安くなる」と書きました。数十秒で終わる短い作業だと、読み取りより書き込みのほうが効いて、逆になります。 どちらが安いかは、使い方で入れ替わります。
Grok Bot にも、同じ課題をやらせてみました
ここまで書いたところで、手元に Grok Bot(xAI のデスクトップアプリ)も入れていたので、同じ課題をやらせてみました。
ただし、同じ条件では測れませんでした。 Grok Bot には、コマンドから動かす口がありません。画面にメッセージを打ち込むしかないので、1課題1回ずつです。時間は、アプリの記録に残っている「送った時刻」と「返事が来た時刻」の差にしました。Claude Code と Codex は道具の起動(1回4〜6秒)も込みで外から測っているので、Grok Bot のほうが数秒ぶん有利な測り方になっています。
| 課題 | Claude Code | Codex | Grok Bot |
|---|---|---|---|
| 小さな修正 | 32秒 | 49秒 | 61秒 |
| バグ修正 | 51秒 | 87秒 | 46秒 |
| 機能追加 | 50秒 | 95秒 | 50秒 |
| 3課題の合計 | 140秒 | 230秒 | 157秒 |
Claude Code と Codex は5回ぶんの数字(課題ごとは中央値、合計は平均)、Grok Bot は1回ずつです。
3課題とも、テストは通りました。 合計では Claude Code、Grok Bot、Codex の順です。バグ修正だけは Grok Bot がいちばん速くて、46秒でした。
中身も少しだけ見えました。Grok Bot もエージェントはクラウドで動いていて、僕のPCでは PowerShell を1課題あたり2〜4回立ち上げるだけでした。Codex は1課題あたり5回前後です。同じ「クラウドのエージェントが手元のPCを触る」形でも、コマンドを何回打つかで時間が変わります。
トークン数も料金も、Grok Bot からは取れません。使ったのは試用枠で、4回で1%から5%に増えました。
そして、ここも1回ずつの数字です。順位を決める材料としては弱いので、参考として見てください。
僕の環境と違えば、結果も変わるはずです
ここは大事なので、はっきり書いておきます。今回の数字は、僕のPCで、僕の設定で、小さな課題を頼んだときのものです。読んでいる方の環境では、順番が入れ替わってもおかしくありません。
変わりそうなところを、今回の条件と並べておきます。
| 変わりそうなところ | 今回の僕の条件 | ここが違うと |
|---|---|---|
| OS | Windows 11 | Codex はコマンドのたびに PowerShell を立ち上げていて、1回あたり約2.7秒かかっていました。Mac や Linux では、この待ちが軽くなるはずです |
| 承認の出し方 | 確認ダイアログを出さない設定 | 毎回許可する使い方なら、そのぶん人の返事待ちが延びます。僕は確認をほとんど出していなくても、質問への返事待ちだけで14日間に12時間ありました |
| モデルと effort | Fable 5.1 と GPT-6 Astra、どちらも high | 考える深さで、1回の応答の長さが変わります。Opus 5 だと high が7.3秒、max が11.1秒でした。2社の high が同じ深さとは限りません |
| 仕事の大きさ | 数十秒で終わる、小さな課題3種類 | 長い作業ほど、往復と書く量が増えます。料金も、短い作業ではキャッシュの書き込みが、長い作業では読み取りが効いてきます |
| プロジェクトと設定 | ファイル5つの小さなプログラム。スキルやプラグインは普段のまま | 読むファイルが多いほど、最初に渡す説明が長いほど、1回目が重くなります。Claude Code は毎回、2万トークン近くを最初に書き込んでいました |
| PCと回線 | 僕の Windows のPCと、普段の回線 | テストやビルドの時間はPCの性能で決まります。回線が遅ければ、応答1回ごとの待ちが延びます |
Grok Bot は、そもそも1回ずつで、測り方も違います。数秒ぶん有利に出ているので、参考として見てください。
なので、「Codex は遅い」とは言えません。 言えるのは、「僕の Windows のPCで小さな課題を頼んだら、Claude Code のほうが約1.6倍早く終わった」までです。
自分のClaude Codeが遅いと感じたら
比べる前に、まず自分のログで分けてみるのがおすすめです。お金はかかりません。僕のスクリプトは Python 1本で、14日分・439ファイルを十数秒で読み終わりました。
見る順番は、この3つです。
- 書く速さ:表の値と大きくずれていないか。ずれていたら、回線やサービス側を疑う
- 時間の内訳:コマンドの実行や承認待ちが大きくないか。大きければ、モデルを替えても速くならない
- 往復の回数:長くかかった指示ほど、往復が増えていないか。増えていたら、頼み方で縮められるかもしれない
3つ目で効きそうなのは、最初の指示に「どのファイルを」「どうなったら終わりか」まで書いておくことです。探す往復と、終わりを確かめる往復が減るはずです。
Claude Code を実務でどう回しているかは、別の記事にも書きました。
▼関連記事
AIが9体、同時に走るコマンドがあった — Claude Codeで実務を回して分かったこと
選ぶなら、自分の使い方に合うものを
じゃあ、どれを使えばいいのか。
僕は、順位より「自分の頼み方だと、どこに時間やお金がかかるか」で選ぶのがいいと思っています。今回の数字から言えるのは、このくらいです。
| 使い方 | 効いてくるところ | 今回の結果では |
|---|---|---|
| 小さな修正を、こまめに頼む | 起動と、1回の応答の待ち | Claude Code が速かった(日付の修正で32秒。Codex は49秒) |
| まとまった作業を任せて、待つ | 往復の回数と、最後まで正しく終わるか | 3つとも全部合格。往復は Claude Code のほうが少なかった(13回と17回)。長い作業は測っていません |
| Windows で使う | コマンドを立ち上げる回数 | Codex はコマンドの待ちが Claude Code の約9倍でした |
| 料金を抑えたい | 1回の作業の長さ | 短い作業では Codex のほうが安かった(1回 $0.35 と $0.55)。長い作業では、キャッシュ読み取りが安い Fable 5.1 が有利になりえます |
| チャットで頼んで、結果を待ちたい | 画面から頼めて、終わったら返事が来るか | Grok Bot はこの形でした。ただし時間やトークン数は外から見えません |
どの道具が速いかを本当に知りたいなら、他人の比較より、自分のPCで同じ課題を何回か回すほうが確かです。普段の仕事に近い小さな課題を3つ用意して、テストで合否を決める。僕の場合は、それで十分でした。
まとめ
「Claude Code は遅い」と言われて、最初は道具の性能の話だと思っていました。
ログを分けたら、書く速さは表のとおりの68 tok/sで、時間を使っていたのは往復の回数と書いた量でした。そこから「たくさん書くから遅いんだろう」と推測しました。
同じ課題で Codex と比べたら、2倍書いた Claude Code のほうが先に終わりました。Grok Bot も1回ずつ試して、合計では Claude Code と Codex の間でした。
推測は、測ったら外れました。
ただ、これは僕の Windows のPCで、小さな課題を頼んだときの話です。OS や承認の出し方、頼む仕事の大きさは、人によって違います。そこが違えば、順番は入れ替わると思います。
なので、「どれがいちばん速いか」より、「自分の使い方だと、どこに時間がかかるか」で選ぶのがいいと思います。小さな修正をこまめに頼むのか、大きな作業を任せて待つのか。確認ダイアログを毎回出したいのか。それで効いてくるところが変わります。
表の tok/s が教えてくれるのは、手を動かす速さだけです。迷ったら、自分のPCで、普段の仕事に近い課題を何回か回してみてください。今回も、書こうとしていた結論より、測った数字のほうが正確でした。
出典
速さの表
- GPT-6 Astra vs Claude Fable 5.1(出力速度) — https://artificialanalysis.ai/models/comparisons/gpt-6-astra-vs-claude-fable-5-1
- Benchmarking GPT-6 Astra(コーディングで使うトークンの量) — https://artificialanalysis.ai/articles/benchmarking-gpt-6-astra
測り方
- Run Claude Code programmatically(
claude -pと--output-format json) — https://code.claude.com/docs/en/headless - Permission modes(auto モード) — https://code.claude.com/docs/en/permission-modes
- Non-interactive mode(
codex exec) — https://learn.chatgpt.com/docs/non-interactive-mode
数字の前提
ログの数字は、2026年9月3日〜16日に僕のPCで動いた Claude Code の記録を集計したものです。ログに所要時間の欄はないため、記録の時刻の差から計算しています。書く速さは、出力が1,000トークン以上の応答の中央値で、最初の1文字が出るまでの待ち時間を含みます。作業の中身は日によって違うので、モデル同士や effort 同士の性能差を示すものではありません。表の値は Artificial Analysis の公開値(2026年9月6日参照)です。
Codex との比較は、2026年9月17日に Windows 11 のPCで、Claude Code 2.1.263(Claude Fable 5.1)と Codex CLI 0.153.4(GPT-6 Astra)を使って行いました。effort はどちらも high で、最初に試運転を1回したあと、課題ごとに5回ずつ実行しています。料金は、Claude Code が出す見積もり額と、GPT-6 Astra の公開単価(100万トークンあたり入力$10・キャッシュ読み取り$1・出力$50)から計算した目安で、実際の請求額ではありません。
Grok Bot(0.55.0)は2026年9月18日に、同じPCで課題ごとに1回ずつ実行しました。コマンドから動かす手段がないため、画面からメッセージを送り、アプリが残す会話の記録の時刻(送信と返信)で測っています。道具の起動にかかる時間は含みません。モデル名・トークン数・料金は公開されていないため出せません。
作りながら覚えたい方へ
Claude Code の回し方は、説明を読むより、1回自分の仕事で動かしてみたほうが早く分かります。うちは各地でその場を用意しています。
- 香川では、非エンジニアの方が1ヶ月で「作る側」に回りました。→ AI×ノーコード ブートキャンプ2026(香川)開催レポート
- 岡山では、ノーコードとClaude Codeで実際にアプリを作る講座をやっています。→ 岡山市ももスタで全6日間のNoCodeBootCampが開講しました(第1回レポート)
- 2026年10月9日は福岡です。地域の中小企業と生成AIの話をします。→ 大名カンファレンス登壇のお知らせ
弊社では、AI開発ツールの選び方や、社内での回し方もご相談いただけます。「使ってはいるが、待ち時間が気になる」という状態から始めて大丈夫です。