 ラピットくん
締切直前に、新しいモデルが出ました
先週、とある申請書を書いていました。締切は9月の初旬。様式が回ごとに差し替わるタイプの書類で、前回のものは使い回せません。全部作り直しです。
で、その山場に Claude Fable 5.1 が出ました。9月1日です。
Xが一気に沸きました。「王座交代」「もう戻れない」。僕のタイムラインも、半分くらいがその話。
正直に言うと、このとき僕が考えていたのは「試したい」ではなくて、「今使っているやつ、替えなきゃダメ?」でした。締切が目の前にある人間にとって、新しい道具の発表は、そんなに嬉しいものではありません。
なので、今週は替えない。そう決めました。
……と思っていたんですが。1週間後にログを開いたら、違いました。
「出た」と「使える」は、別の話
先に、前提を整理しておきます。
新しいモデルって、だいたいこの順番で降りてきます。
1. 発表(プレスリリース・デモ動画) 2. 一部の組織・一部プランに先行提供 3. 一般の有料プランに展開 4. API・各クラウド(AWS / GCP / Azure)に搭載 5. プランごとの利用枠・上限が確定
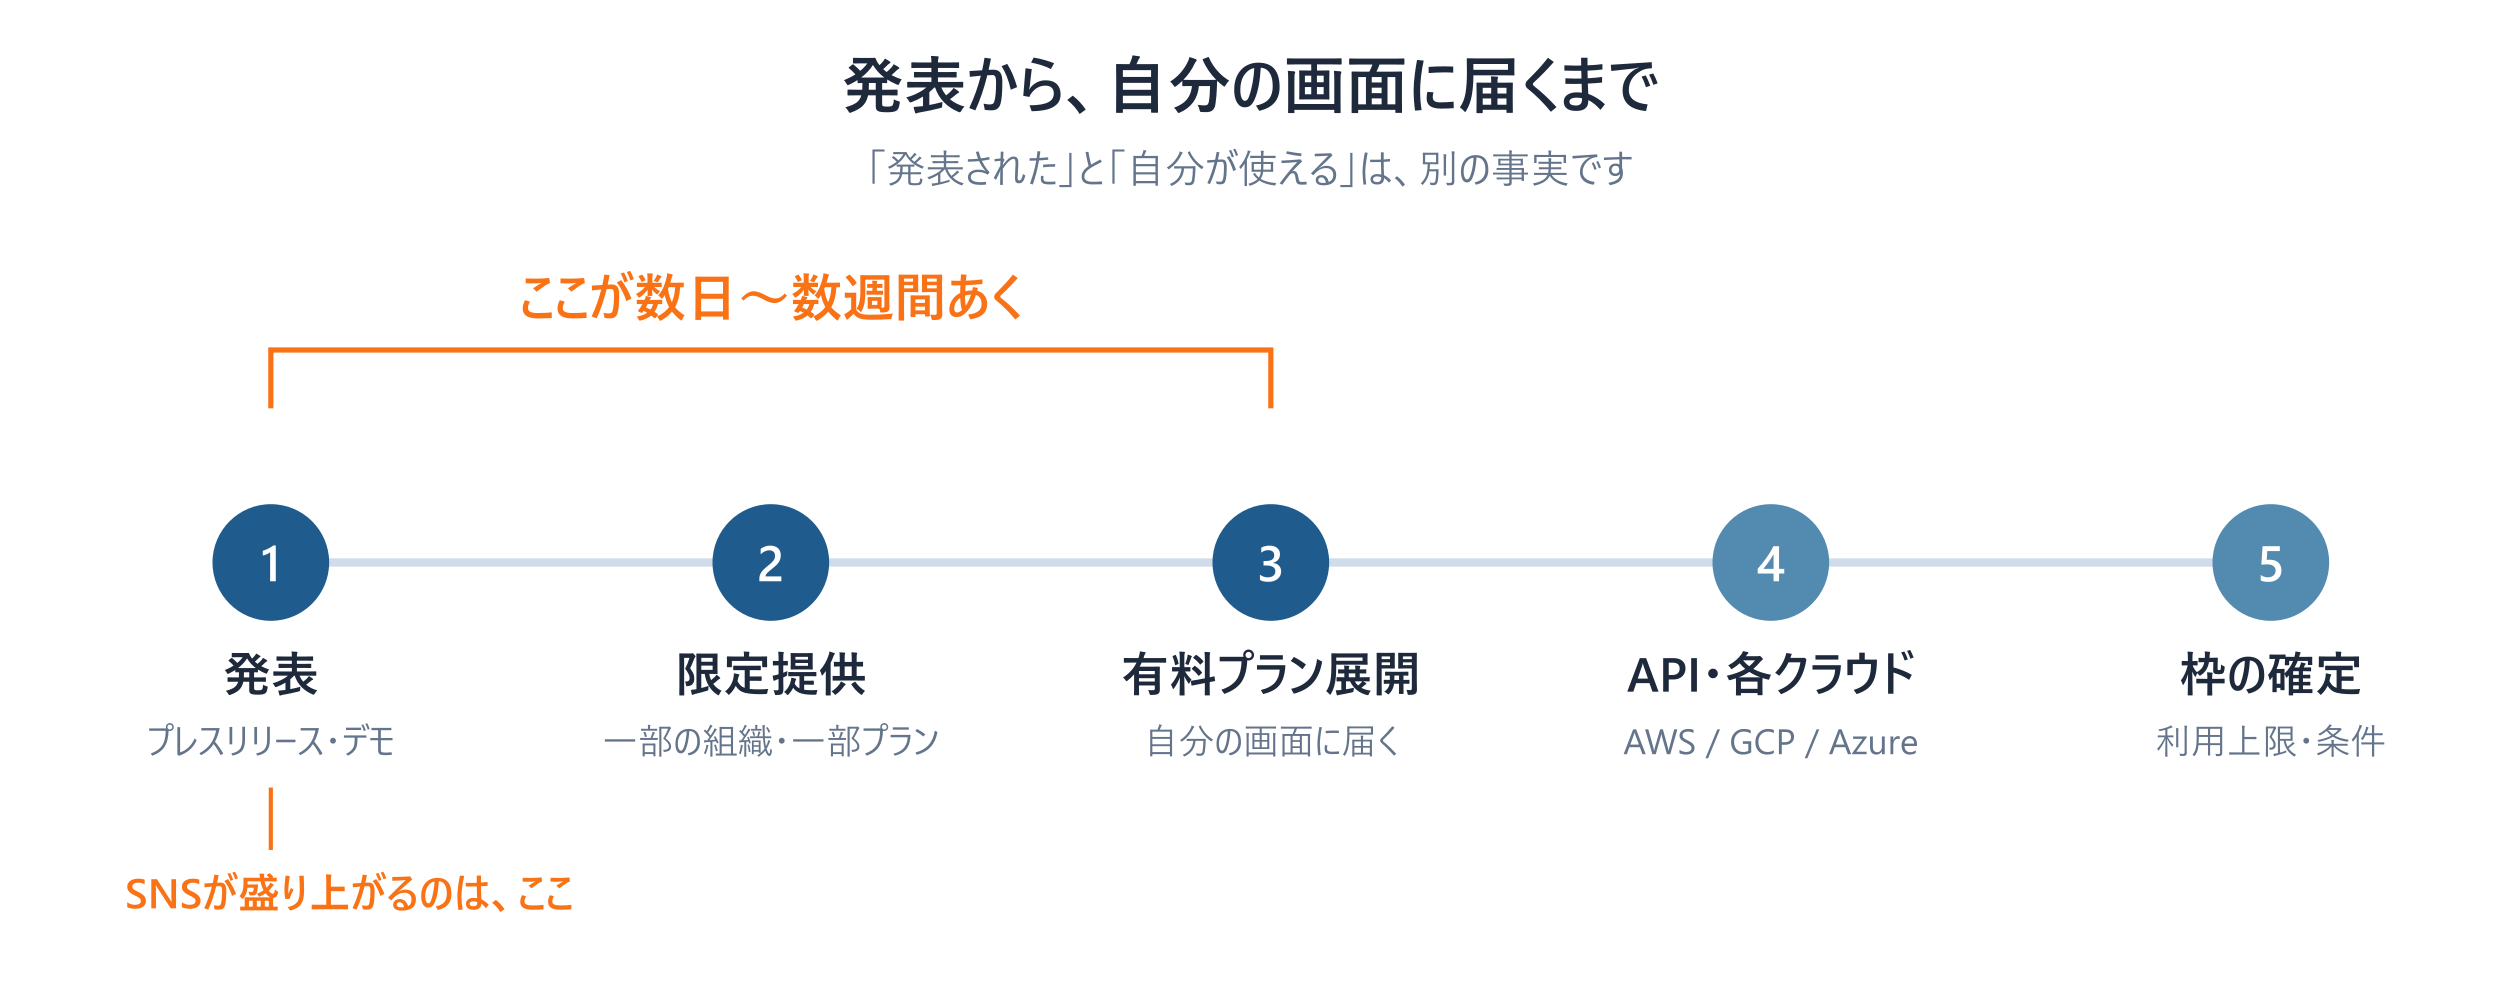
厄介なのは、1と3の間が数日〜数週間あくことです。
しかも3で来たとしても、「どの入口で使えるか」が分かれます。普通のチャットには来なくて、開発者向けの入口にだけ来る、みたいな配られ方がある。同じプランを払っていても、触れる場所が違う。
なので発表を見たとき、最初にやるべきは比較記事を読むことじゃありません。自分の画面のモデルピッカーを開くことです。これで話の半分は終わります。
※ 提供状況・プラン条件・価格は日単位で変わります。判断する前に、各社の公式ドキュメントとご自身のアカウント画面をご確認ください。
僕が替えるかどうかを決めている、3つの問い
道具を替えるか迷ったとき、自分が何を見ているのか。言葉にしてみたら、この3つでした。
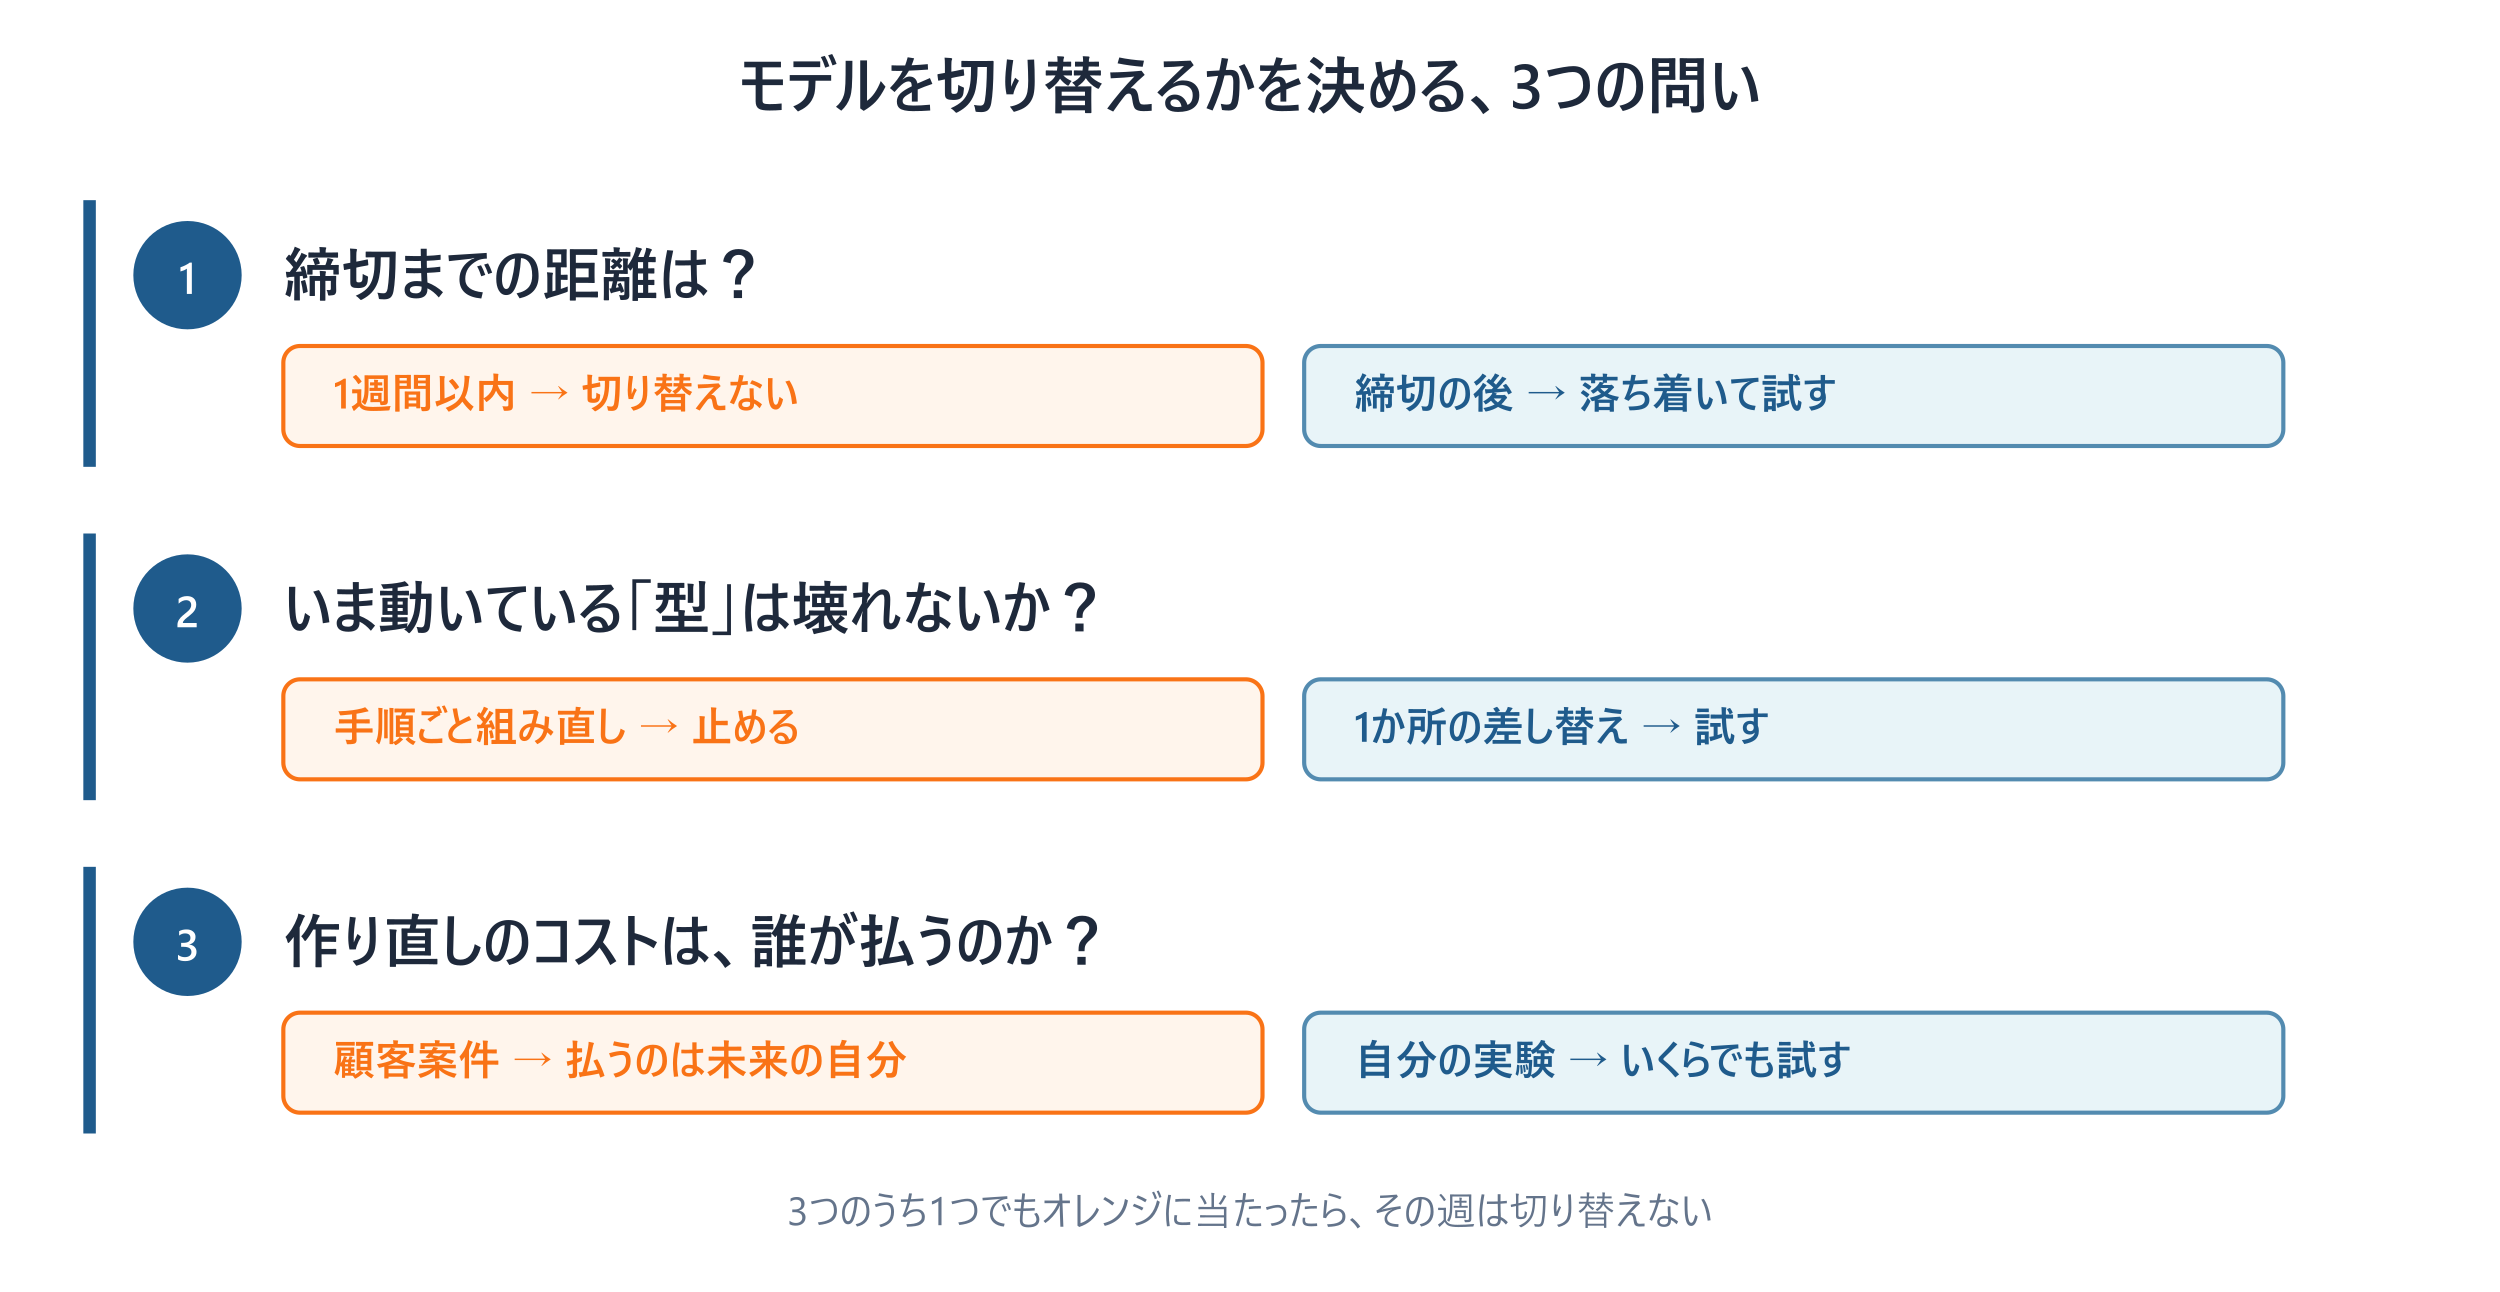
問1:締切まで、あと何日? 数日しかない。新しいモデルは出力の癖が変わります。癖が変わると原稿の文体がズレる。ズレると、数十ページを目視で読み直すことになる。それは無理。
問2:今動いている「型」は壊れない? 8月末に、設計を考えるセッションと実装するセッションを分ける運用にしました。考える側と手を動かす側で、モデルも変えています。片方だけ新しくすると、噛み合わせが変わるかもしれない。
問3:作り直しのコストは、誰が払う? 自分の実験なら、いくらでも試せばいい。でも今回は締切のある書類です。失敗したら払うのは未来の自分。
3つとも「今週は替えない」でした。
1週間後、ログを開いてみた
Claude Code はセッションの記録をPCに残しています。使ったモデル、トークン、設定。全部です。
集計しました。2026年7月20日〜9月4日、リクエスト62,541件。
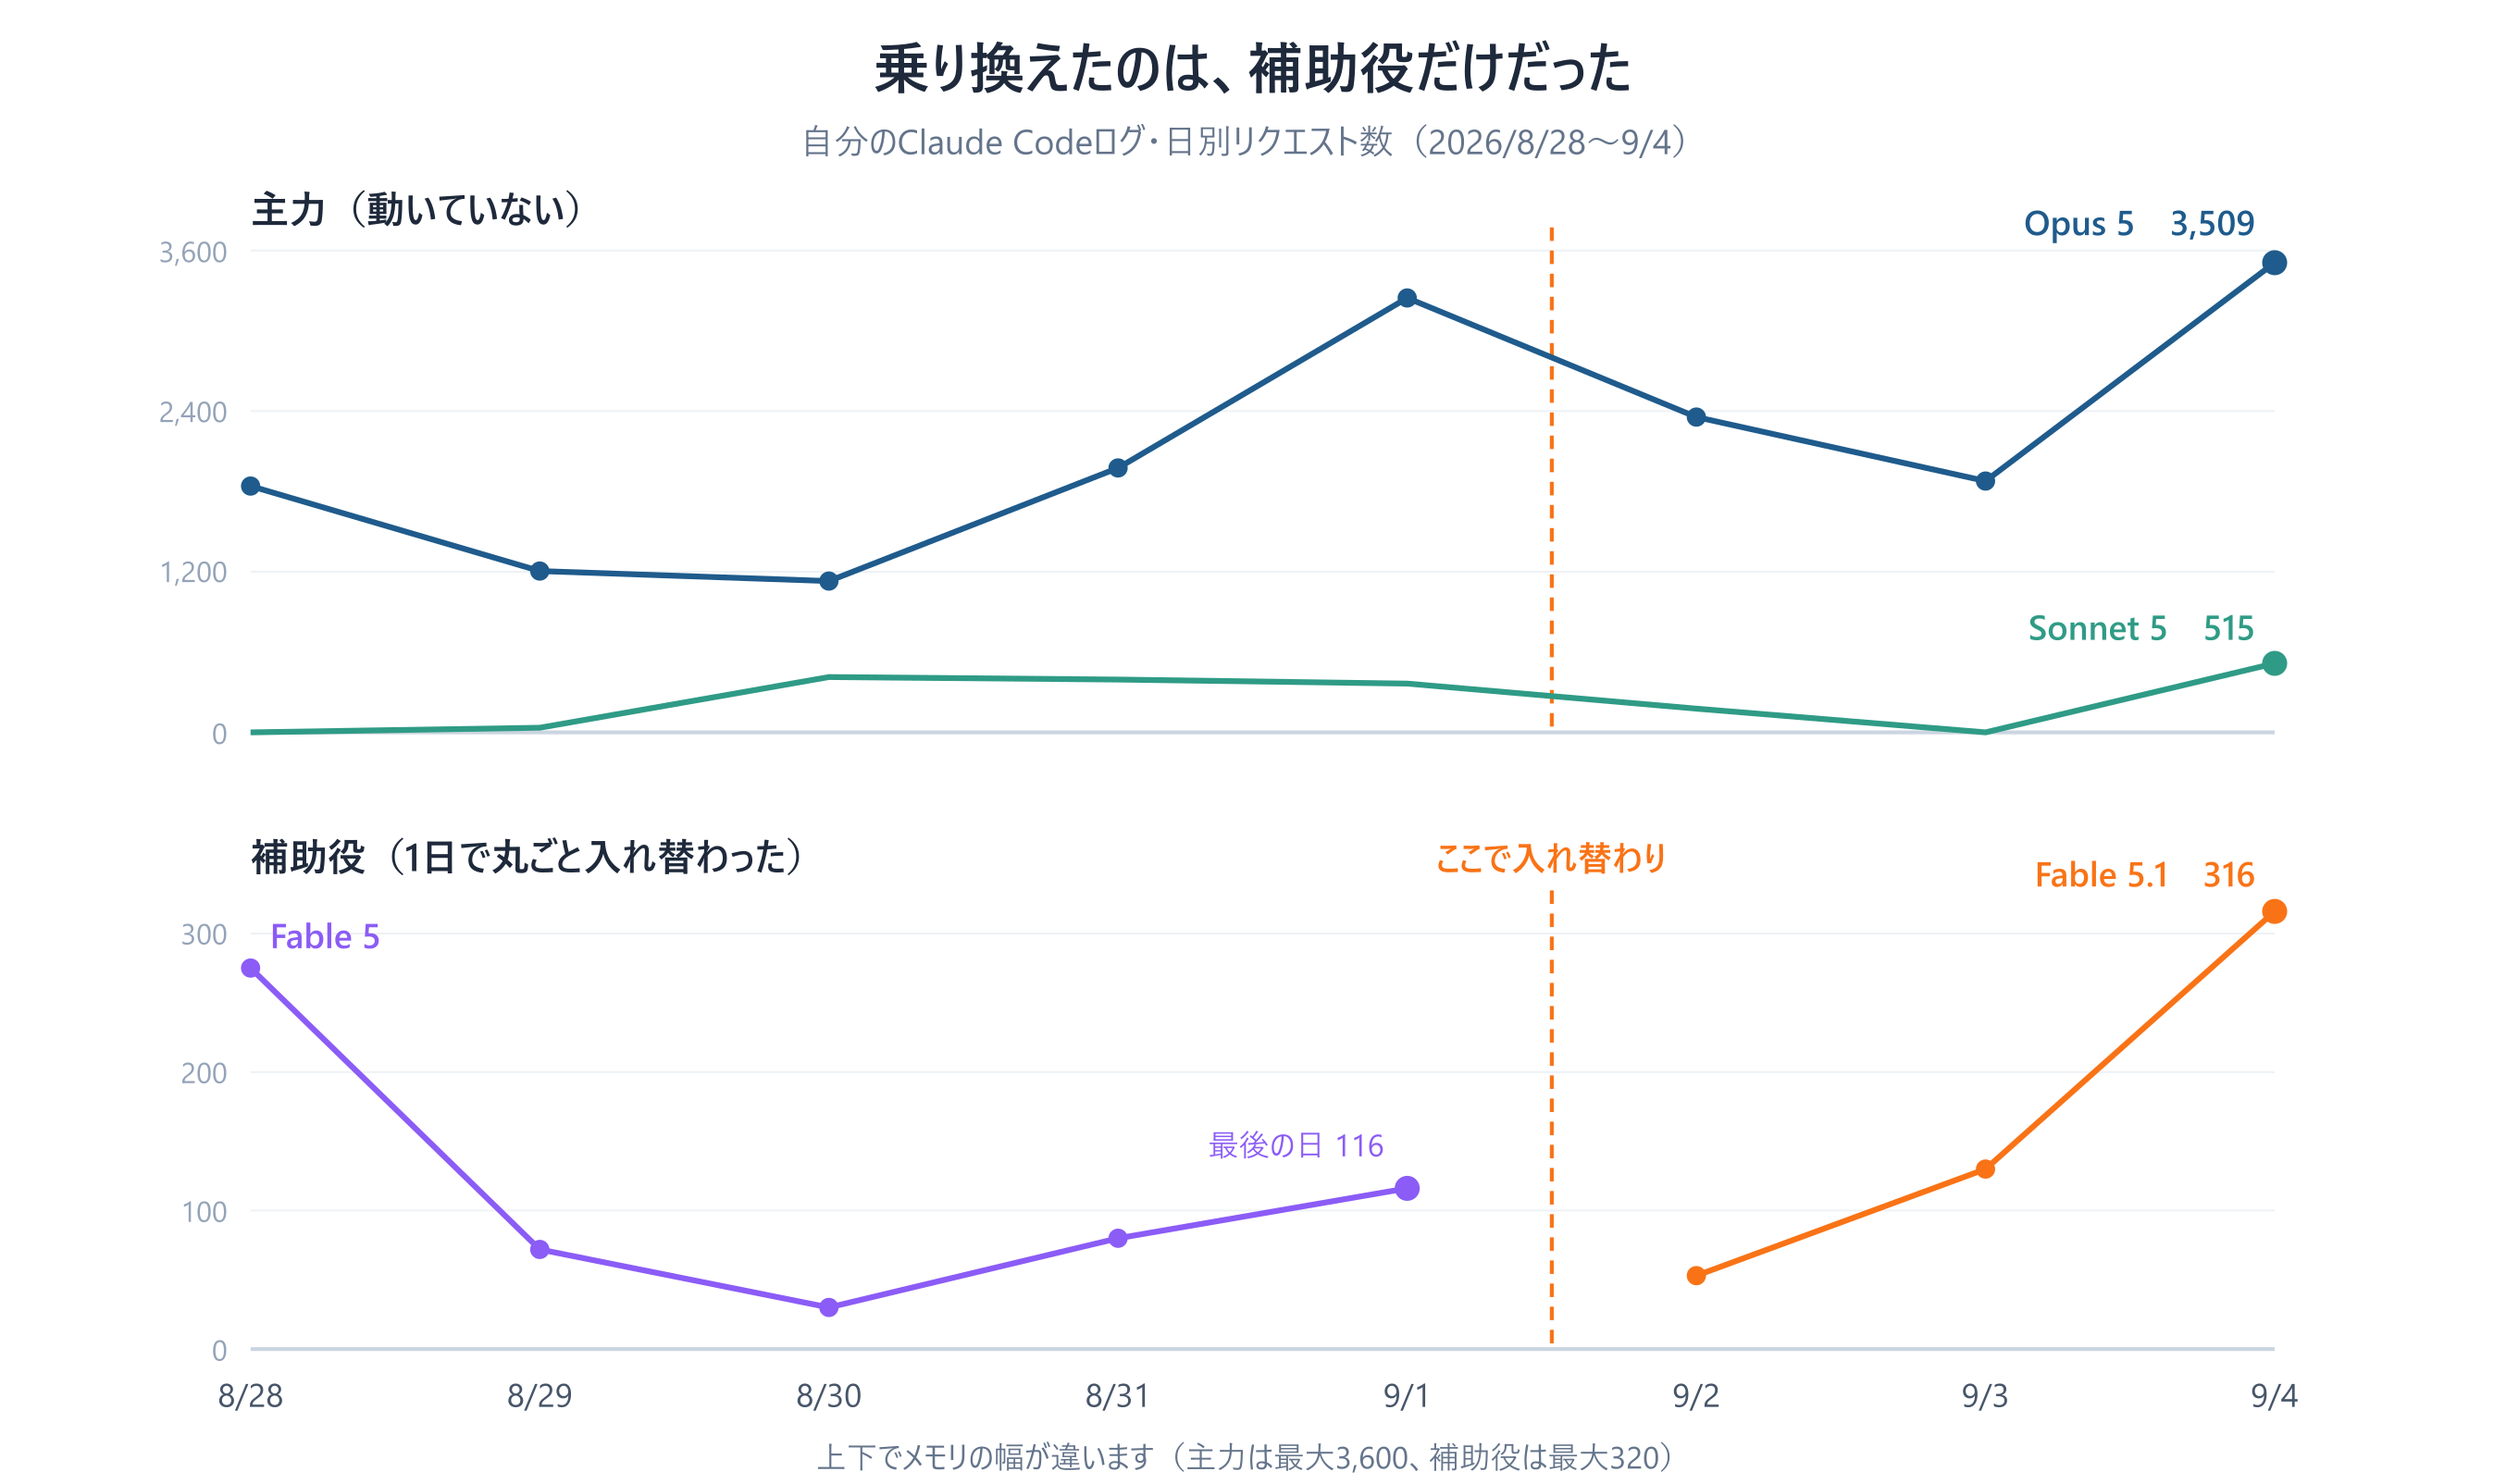
Fable 5 の最後の呼び出しは、9月1日の15時台。Fable 5.1 の最初の呼び出しは、9月2日の午前2時台。それ以降、古いほうは1回も呼んでいません。
段階移行とかじゃない。ある日を境に、丸ごと入れ替わっています。「替えない」と決めた、その翌日です。
これは、ちょっと恥ずかしかった。
でも、矛盾はしていなかった
もう一度グラフを見て、気づきました。入れ替わったのは補助役だけです。
主力の Opus 5 は、9月1日が3,246リクエスト、9月4日が3,509リクエスト。発表の前後で何も変わっていない。指一本触れていません。
一方で補助役は、9月1日が116、9月4日が316。全部新しいほう。
要するに僕は、同じ週に「替えた」と「替えなかった」を両方やっていたわけです。場所が違うだけで。
3つの問いのうち、実際に効いていたのは問2だけでした。補助役はそこだけ差し替えても手順が壊れない。主力を替えると型ごと組み直し。
締切までの距離(問1)は、あとから理由をつけただけでした。締切が目の前でも、壊れない場所は迷わず替えている。3つで判断しているつもりで、実際は1つしか見ていなかった。
もう1個、思い込みが外れました
僕はこれまで、人にこう説明してきました。「コストを抑えたいなら、思考の深さ(effort)を下げればいいですよ」と。
で、自分はどれくらい下げているのか。数えてみました。
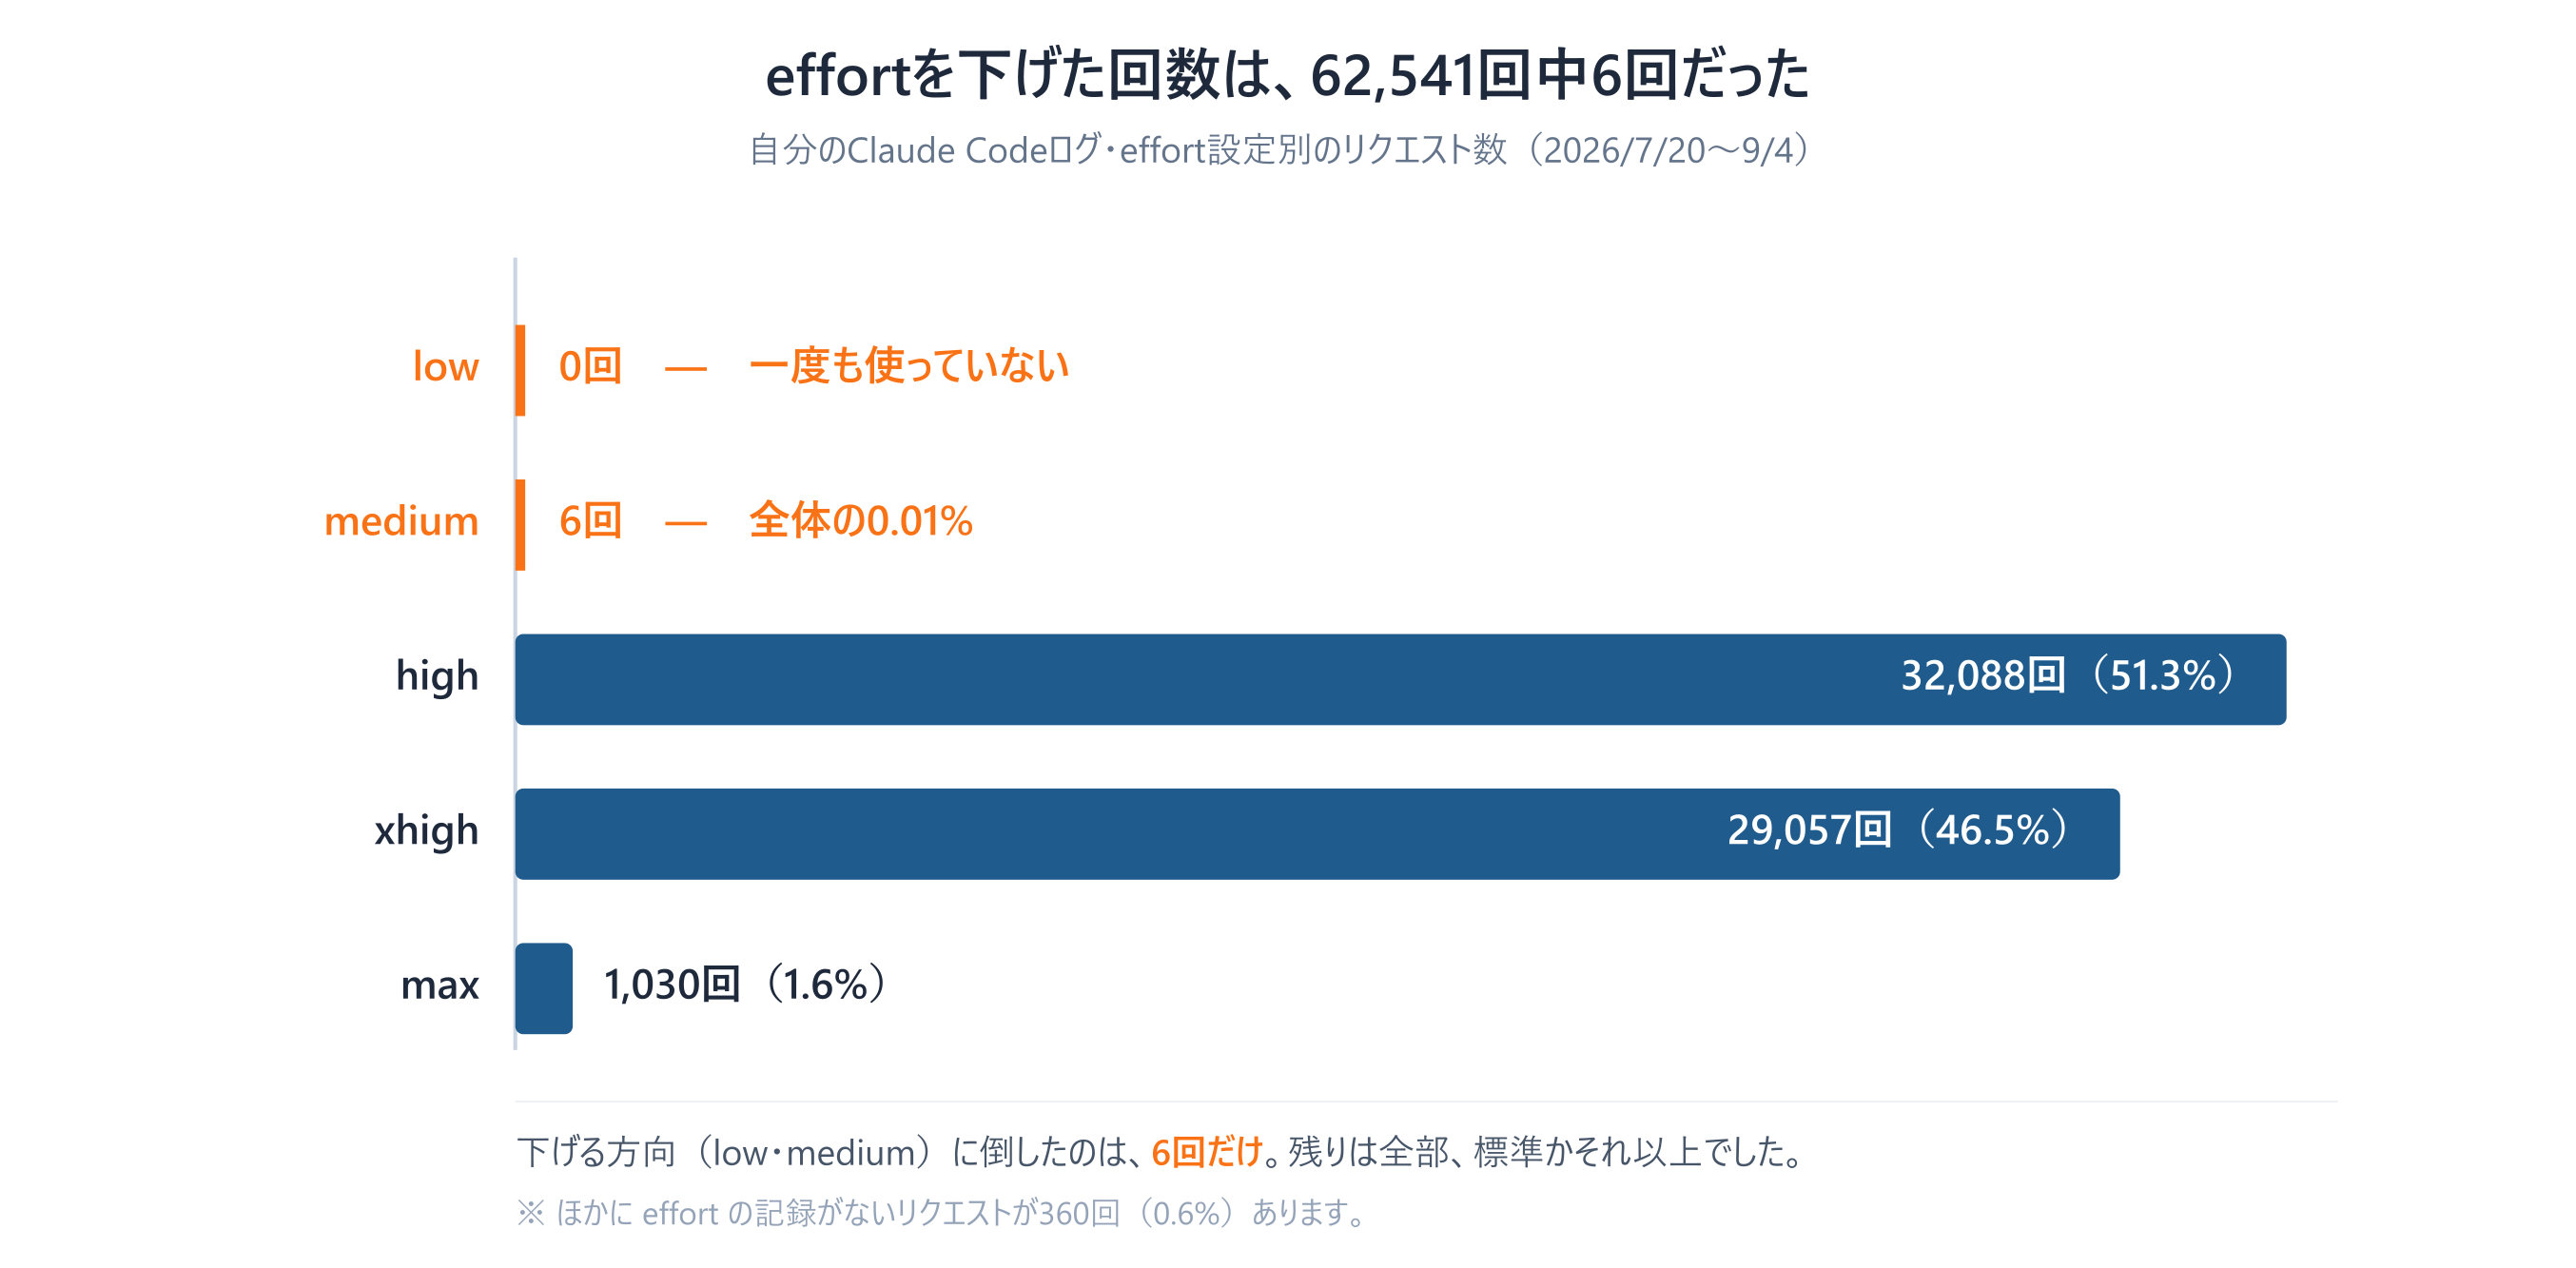
low はゼロ回。medium は6回。62,541回のうち、6回です。
残りは high 51.3%、xhigh 46.5%、max 1.6%。標準か、それより上しか使っていない。
もっと言うと、新しい Fable 5.1 だけ max が12%あります。Opus 5 は2%。下げるどころか、新しいモデルには一段上げて使っていました。
説明と実態が違っていた、という話です。「effortを下げるとコストが下がる」は事実ですが、僕自身は締切前にそれをやっていない。品質のブレを引き受ける余裕がなかった、ということだと思います。
Fable 5.1 は、同じ席で2.7倍考えていた
もう1つ動いていた数字があります。
1リクエストあたりの思考トークンが、Fable 5 の353から、Fable 5.1 では947に増えました。約2.7倍。 出力に占める思考の比率も25.7%→48.5%。出力そのものも1,375→1,953。
同じ「設計を考える側」に置いていたモデルです。役割は変えていません。
ただ、これは厳密な比較じゃないです。作業の中身が同じじゃない。 9月2日以降のほうが申請書の詰めに寄っていて、数字が増えたのがモデルのせいなのか作業の難しさのせいなのかは、このログだけでは分けられません。
それでも、体感の裏づけにはなりました。同じ席に座らせたのに、明らかによく考えている。だから max を選ぶ回数も増えたんだと思います。
数字の出どころ
この記事の数字は、僕のPCに残っている Claude Code のセッションログ(~/.claude/projects/ 配下のJSONL)を集計したものです。ベンチマークでも、他人の測定でもありません。
- 期間:2026年7月20日〜9月4日
- 対象:使用量の記録がついたリクエスト 62,541件
- 項目:モデル名、effort設定、入出力トークン、思考トークン、キャッシュ読み取り量
ついでに見つかったこと。入力トークンの94〜98%が、キャッシュの読み取りでした。 毎回まっさらに読み直しているわけじゃなくて、ほとんど使い回し。長いセッションを回す作業だと、ここが効きます。
あと、この使用量をAPIの定価に換算すると、47日間で約$15,700になります。実際に払っているのは定額プランの料金なので、これは「もし従量課金だったら」の仮の数字です。 定額プランがどれくらい効いているかの目安として置いておきます。
新しいモデルが出たとき、僕が見る4つ
今回のことで、順番が決まりました。
- 自分のアカウントの画面に、実際に来ているか(発表じゃなくて、モデルピッカーを見る)
- 来ているとして、どの入口か(普通のチャット/開発者向け/API/各クラウド)
- 替えようとしている場所は、主力か補助役か(ここが一番効く)
- 替えると、手順のどこが組み直しになるか(モデル単体じゃなくて、手順ごと見る)
3つ目を先に決めておくと、締切前でも迷わなくなります。補助役なら、締切前でも替えていい。 実際、僕はそうしていました。
おわりに
この記事、最初は「発表を追うのと仕事を進めるのは別作業だ」という話を書くつもりでした。締切前は新しい道具に手を出さない、と。
ログを見たら、そうしていなかった。壊れない場所は、翌日に全部替えていた。
書こうとしていた結論より、実際にやっていたことのほうが、たぶん正確です。
比較記事に載っているのは他人の画面で、自分がどう判断したかは自分のログにしか残っていません。一度、開いてみてください。僕は、自分の説明が実態と違っていたことに気づきました。
※ 本記事の数値は、2026年9月4日時点で僕のPCに残っていたログを集計したものです。 モデルの提供状況・価格・設定名は予告なく変わります。判断にあたっては各社の公式ドキュメントと、ご自身のアカウント画面をご確認ください。
出典(2026年9月6日 参照)
- Introducing Claude Fable 5.1 and Claude Mythos 5.1 — Anthropic
- LLM Leaderboard — Artificial Analysis
▼関連記事
株式会社AppTalentHub は、中小企業のAI・DX導入を「つくる側に回る」視点で支援しています。導入前の要件整理から、実装、社内定着までご相談ください。