 宮崎翼
今までのAIは、「1話まるごと描いて」は、まだ無理だった
やってみて分かったのは、画像生成AIは「1コマ」は描けるけれど、「1話」は描けないということでした。
つまずいたのは3つです。
ひとつ、顔が変わる。同じ「源田テツ」を頼んでも、コマごとに別人が出てきます。40コマ描いたら40人います。
ふたつ、コマ割りを覚えていない。「4コマの縦割りで」と言えばそれっぽい絵は出ますが、次のページでは忘れています。どのコマから読むのかも、毎回変わります。
みっつ、続きから描けない。会話を閉じたら、さっきまでの設定は消えます。翌日また同じ説明を書くことになる。
1コマずつなら出せる。でも41コマ分を、同じ顔・同じ絵柄・決めた並びで出し続けるのは、手作業では回りませんでした。
だから、フォルダを正本にした
そこで作ったのが name-maker です。ローカルで動く、一言書けば、コマ割りから、作画まで1話分すべて作成してくれるアプリです。
1話分がそのまま1つのフォルダで、中身はこうなっています。
<話フォルダ>/
  構成.md      話の運び。一行のネタから、ここを起こす
  ネーム.json  コマ割り・人物・セリフ(このアプリの正本)
  素材/        キャラクターシート、絵柄の見本
  作画/        採用したコマの画像(P1-コマ2.png など)
入稿/ 配信各社へ渡す p001.png …たとえば第4話は、「岡山の名物料理で、1話」とだけ入れて作りました。そこから先はぜんぶファイルになって出てきます。話の運びが 構成.md に、コマ割りとセリフとオチが ネーム.json に、コマの絵が45枚、書き出した原稿が12ページ。
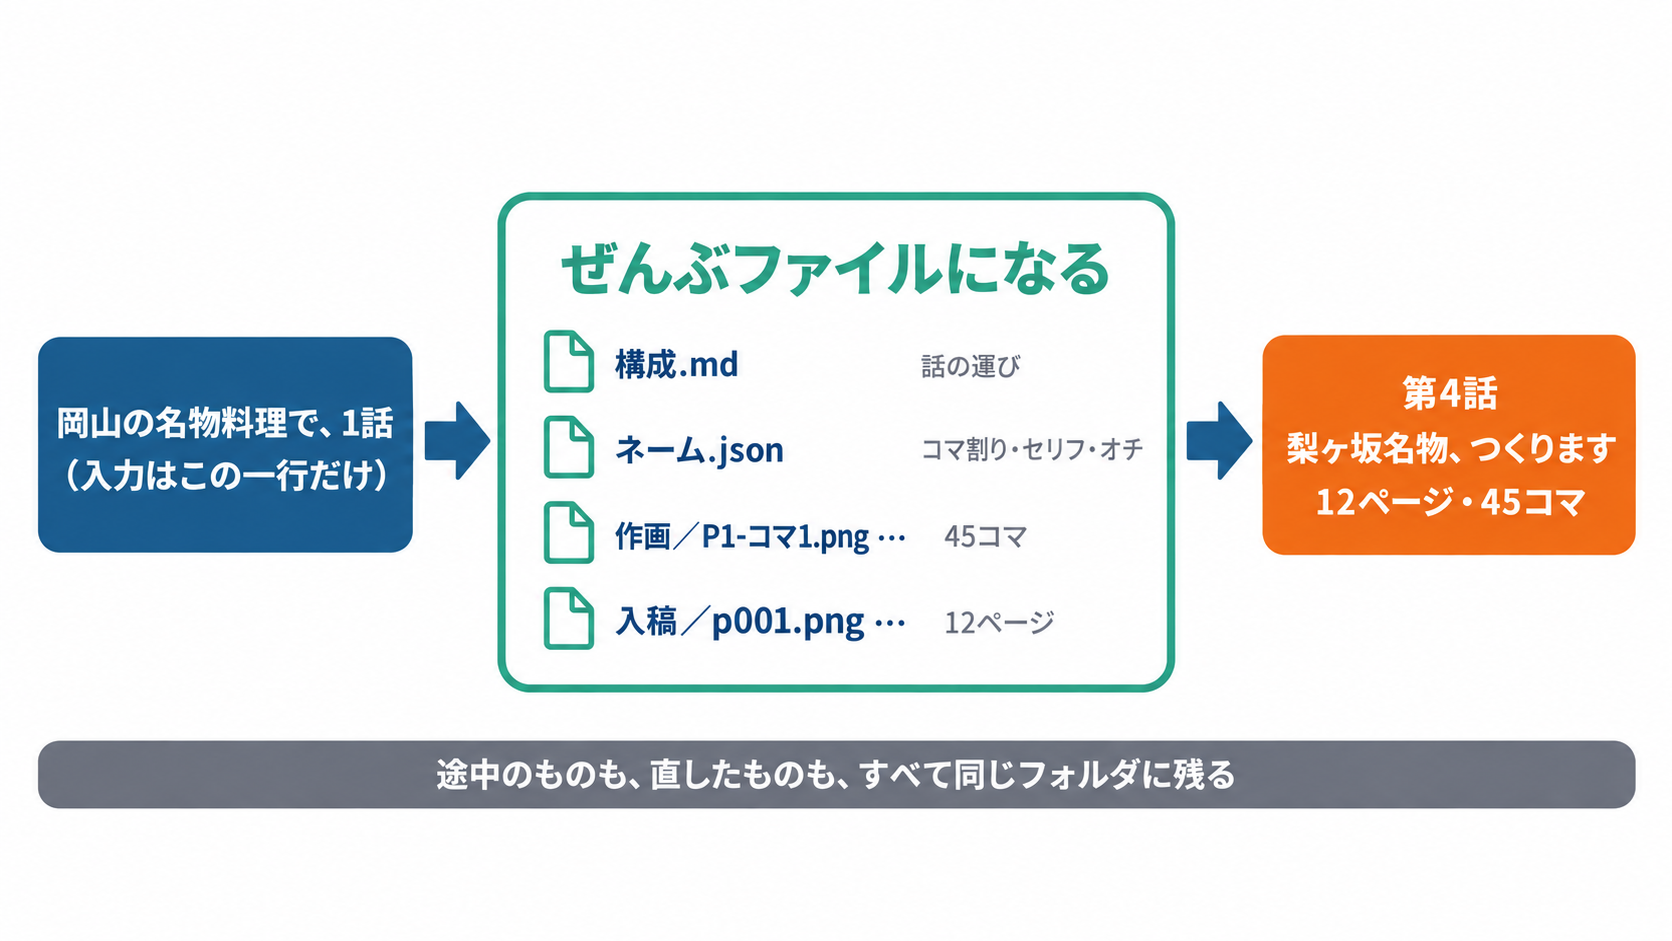
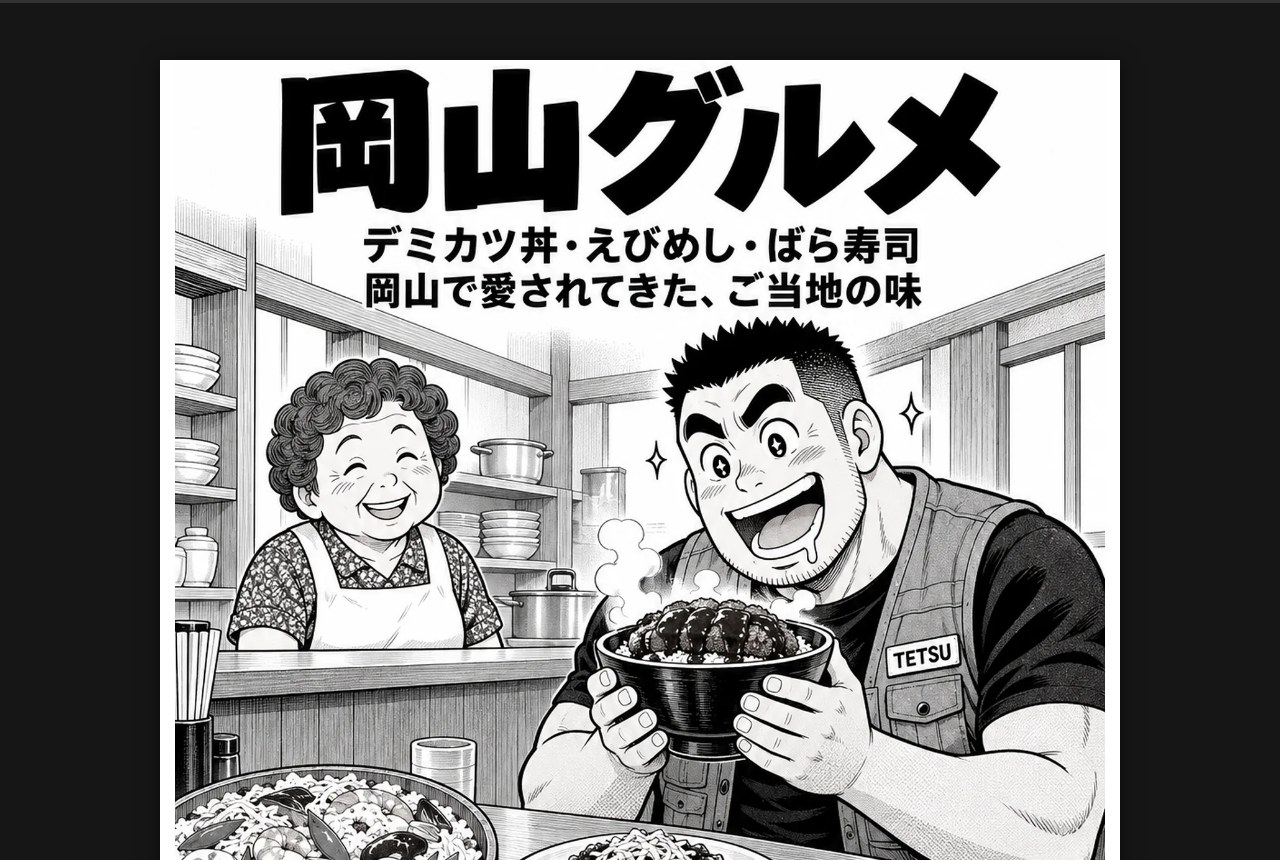
できあがったのが、この話です。
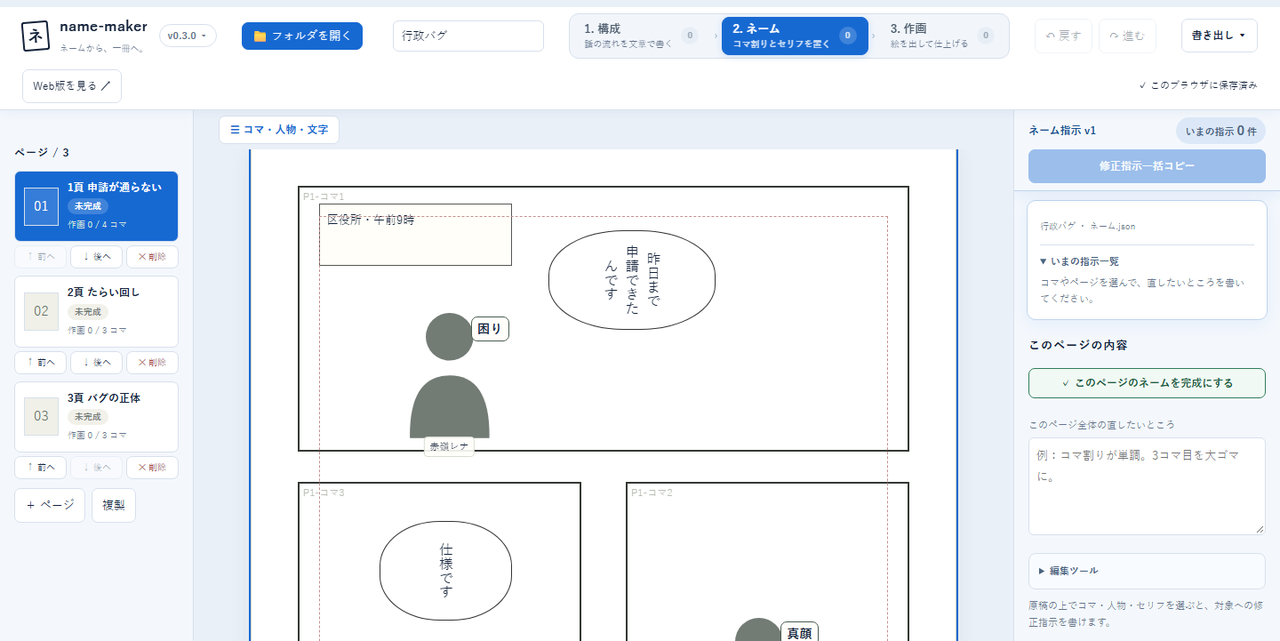
フォルダを開くと、そこにあるものを読み込んで続きから描きます。無いものは白紙から始めます。構成.md だけ置いたフォルダを開けば、ページ見出しごとに空のページが用意されて、そのままネームに進めます。
要するに、続きの記憶をAIの中ではなく、フォルダに置いたということです。おかげで、1ヶ月前に触った話でも、フォルダを開けばそのまま続きから描けます。編集は手が止まって0.8秒で自動保存。置き換わる前の ネーム.json は _backups/ に10世代残ります。
外から入れる依存パッケージはゼロで、node dev-server.mjs を叩くと 127.0.0.1:8788 で待ち受けます。APIキーを入れない限り、画像生成APIは1回も呼びません。
コマ割りは、AIに決めさせないことにした
ここが分かれ目でした。
コマ割りまでAIに任せると、毎回ちがう形が出てきます。読者からすると、ページをめくるたびに読み順の法則が変わる。これは読みづらい。
なので、コマの形はこちらが型として持つことにしました。「右に大ゴマ、左に3段」「上段が横長で、下がぶち抜き」といった型をいくつか用意して、ページごとに当てはめます。
決めごとも足しました。
- 横の溝は44px、縦の溝は16px。横を太くすると、段の読み順で迷わなくなります
- 山場は大ゴマにする。ページの中でいちばん大きいコマが、そのページの見せ場と一致するように
- 会話だけのコマには背景を描かない。全部のコマを描き込むと、どこを見ればいいか分からなくなる
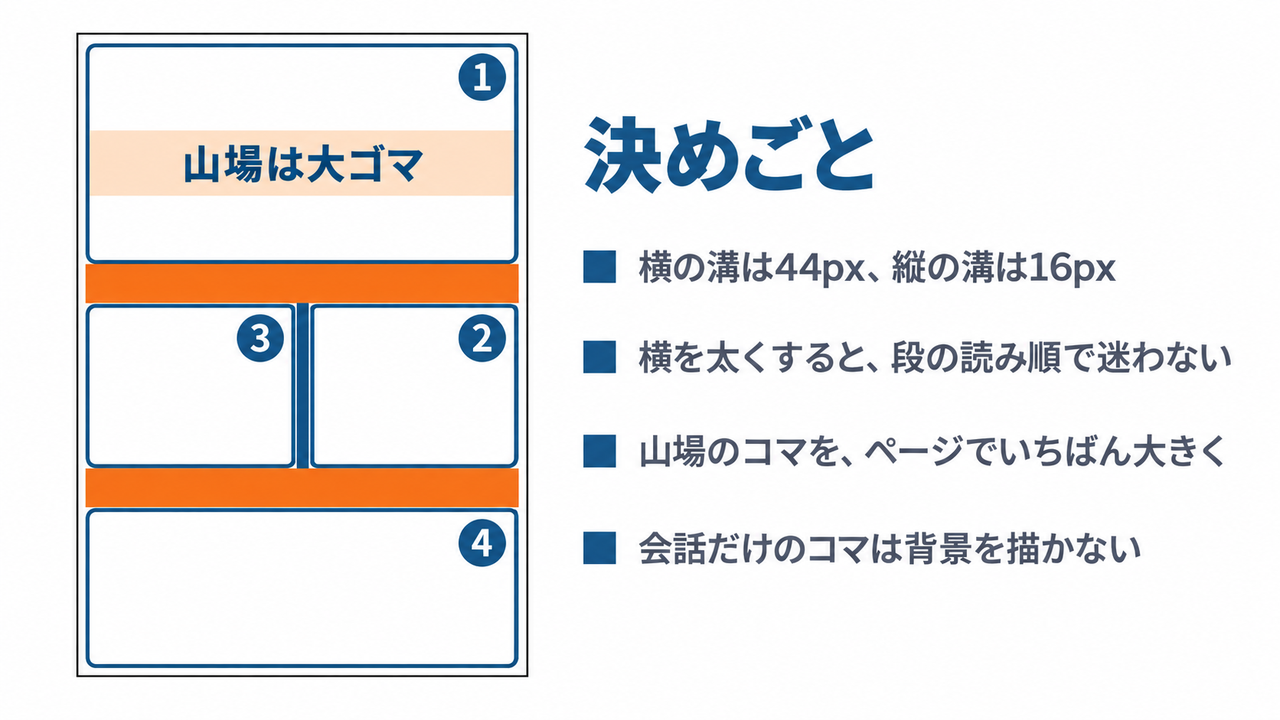
AIに投げるのは「このコマの中身」だけ。画面の設計は人間が持つ。この線引きにしてから、ページが安定しました。
型どおりに組むと、こうなります。第1話の4ページ目です。
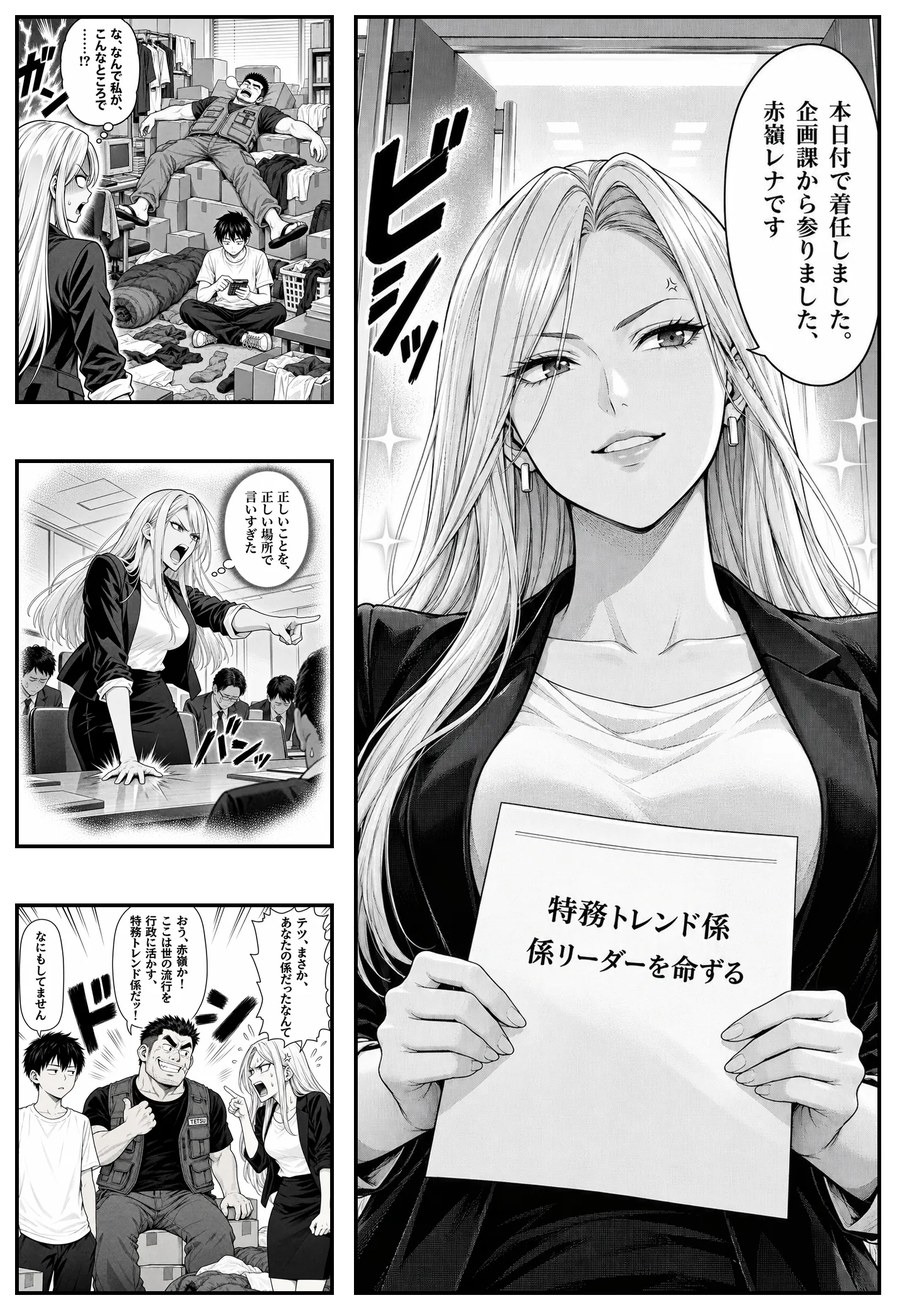
右の大ゴマが、このページの山場です。左の3段は、そこへ持っていくための流れ。段のあいだの横の溝が太いので、右の大ゴマを読んだあと、目が迷わず左の上に戻ります。
顔がぶれるので、立ち絵を「正」にした
顔の問題は、参照画像で解きました。
キャラクターごとに立ち絵を1枚ずつ用意して、それをシリーズの「正」と決めます。コマを描かせるときは、その立ち絵を毎回添付する。文章で「丸みのある四角い輪郭、太くて短い眉」と書くよりも、1枚貼るほうが確実に効きます。
同じ参照画像を何度も送ることになるので、ここも仕組みで軽くしました。参照画像は内容のハッシュで1つだけ保存して、各ジョブからはハードリンクで共有します。導入したとき、生成用フォルダは11フォルダ23MBから5フォルダ5.6MBになりました。
それでも、ぶれるときはぶれます。ぶれたら描き直す。候補として並べて、確認してから採用する作りにしてあるので、気に入らない絵がそのまま本編に入ることはありません。
赤が混ざる。だから、数えて弾くことにした
白黒の漫画です。なのに、生成された絵にうっすら赤が混ざることがありました。
目で見ても気づかないくらいの色みです。並べて初めて「この1枚だけ紙の色が違う」と分かる。
これは目視をやめて、数えることにしました。1枚ごとに、赤成分が青成分を上回る画素(R−B>12)の割合を出します。0.2%を超えたら色が混ざっていると判断して、白黒に落としてから採用する。
この検査を全話にかけたら、5話ぶんにまたがって12枚が引っかかりました。自分の目では見つけられていなかった枚数です。
網点の濃さ(32〜56%)と、白いまま残っている面積(50%未満)も一緒に測っています。数えられるものは、目で見ない。これは漫画に限らず、AIに絵を出させるときの原則だと思っています。
やったらできた。45コマの1話が、その日のうちに
9月19日、岡山のご当地名物をネタにした話を1本、朝から作りました。
脚本を書いて、ネームに落として、45コマを描いて、書き出して、公開まで。同じ日の夕方には、ブラウザで読める状態になっていました。
いま、公開しているのは3話です。第1話が41コマ、第3話が51コマ、第4話が45コマ。扉絵を入れて、それぞれ12ページあります。
もちろん一発ではありません。「セリフが吹き出しからはみ出している」「このコマは要らない」といった直しが、1話あたり何度か入ります。ただ、直しの単位がコマなので、1コマだけ描き直して差し替えられる。ページ全体を作り直さずに済むのが、いちばん効いています。
実際に出てきたコマを、4枚だけ
言葉で説明するより、出てきた絵を見てもらうほうが早いと思います。第1話「秒で消える体育館」から4枚。どれも、ここまでに書いた仕組みで出したものです。
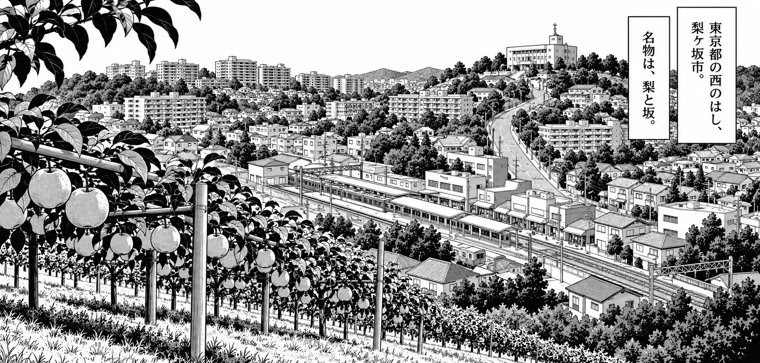
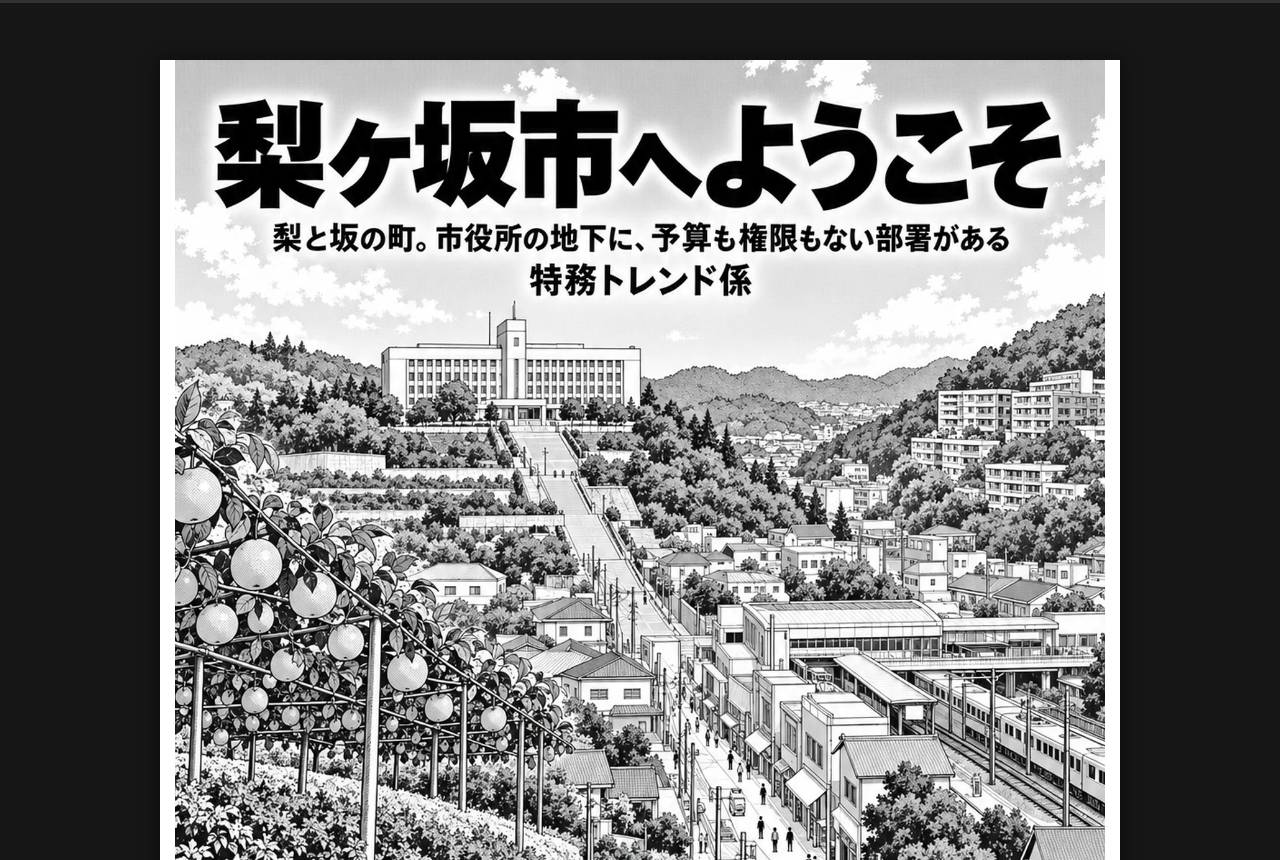
最初の1コマです。町を見せるコマは背景を描き込みます。ここで「どういう町の話か」を1枚で済ませておくと、あとのコマで説明しなくて済みます。
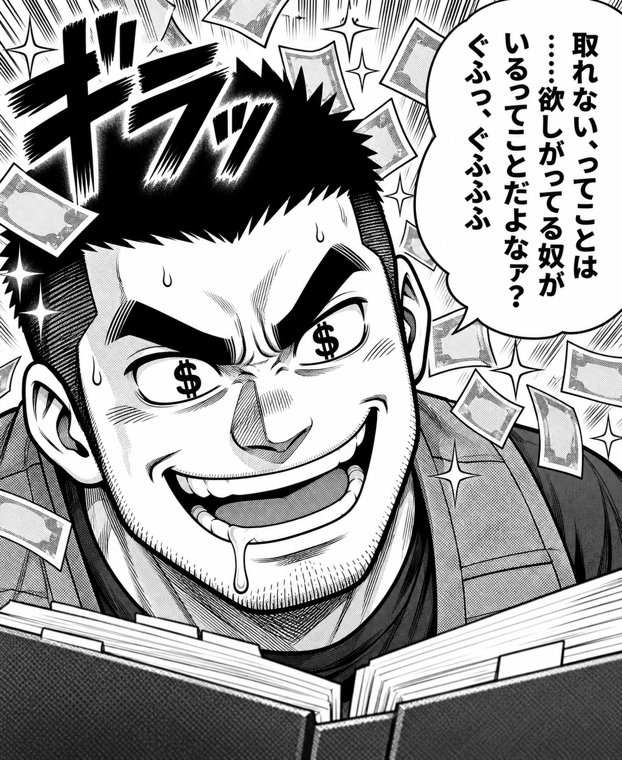
山場の大ゴマ。顔のアップは、キャラクターの立ち絵を参照画像に渡して描かせています。40枚描いても同じ顔で出てくるのは、この1枚のおかげです。
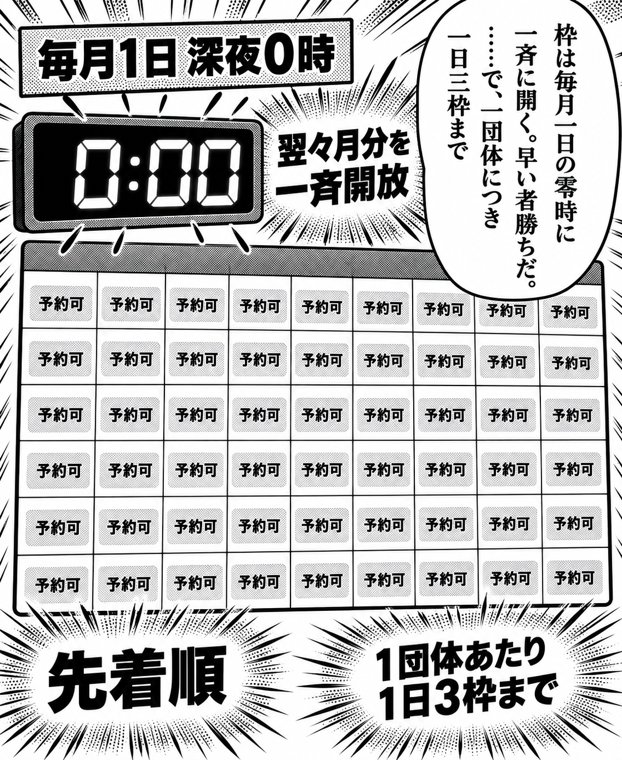
制度を説明するコマ。ギャグ漫画とはいえ、題材が制度なので、こういう「図解のコマ」が毎回出てきます。文字の多いコマでも、書く文言を一字ずつ指定すれば崩れずに出ます。
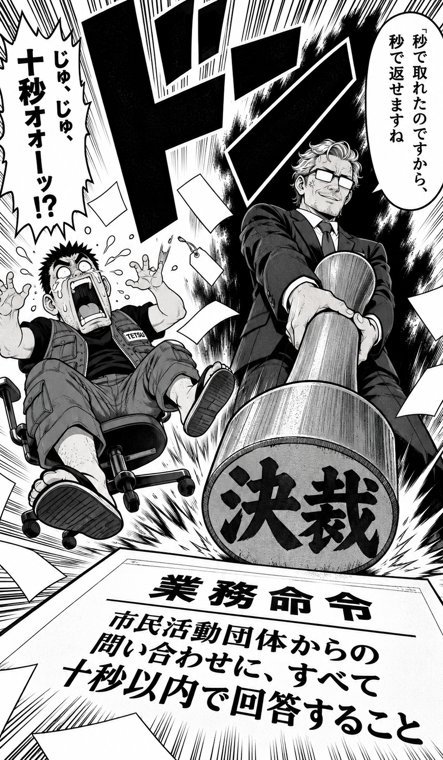
オチのコマです。毎回、テツは課長に怒られて終わります。
このコマが入っているページ全体だと、こう見えます。第1話の10ページ目です。
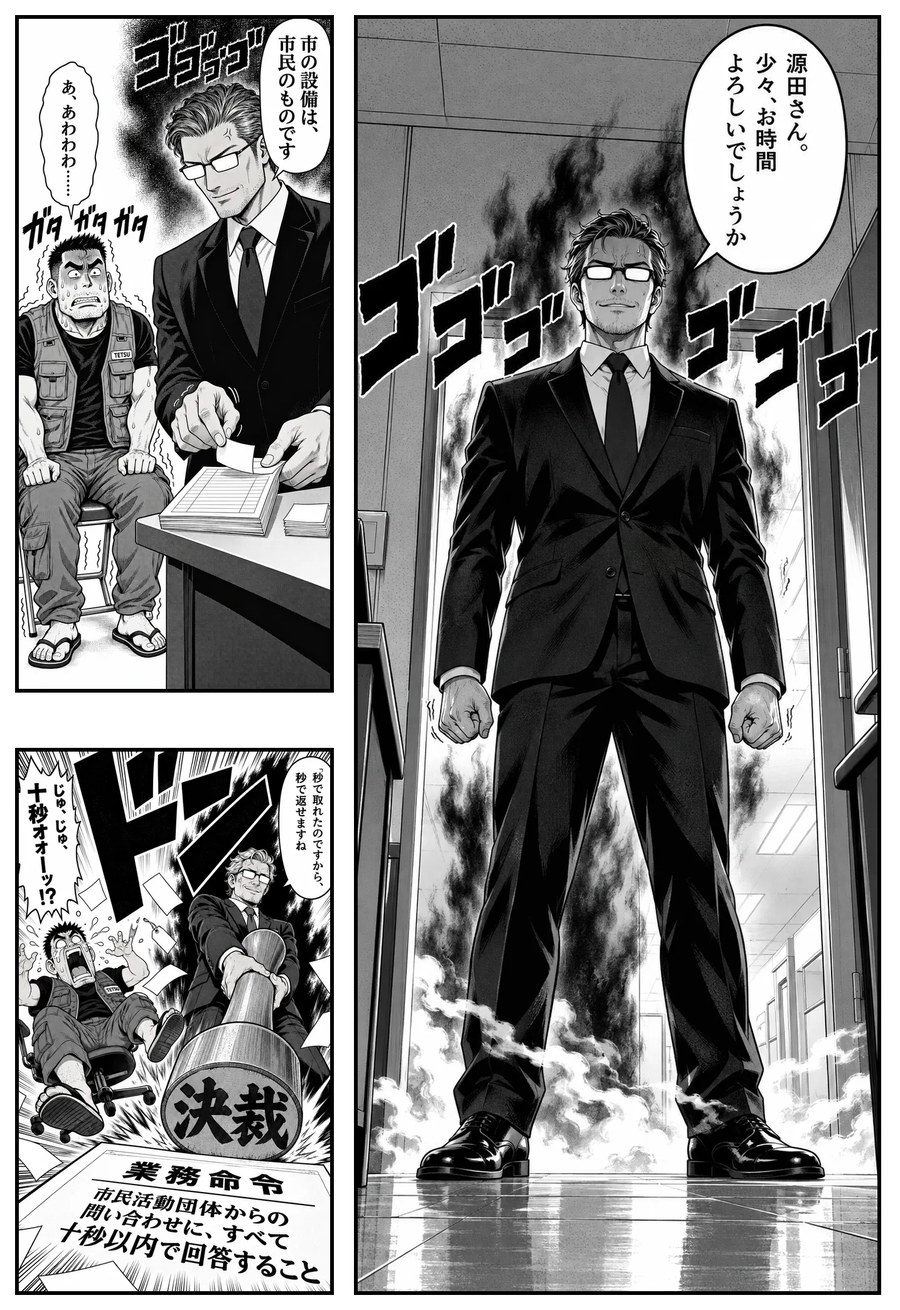
コマ単体で見るのと、ページで見るのは別物です。 1枚ずつは良くても、並べたとたんに「どこから読むのか分からない」ページになることがあります。だからコマ割りだけは、AIに渡さずに手元で持っています。
残りのページは、公開ページでそのまま読めます。
1日で186枚出して、99枚だけ残した
どれくらいの量が出るのか、9月20日の1日ぶんを数えてみました。
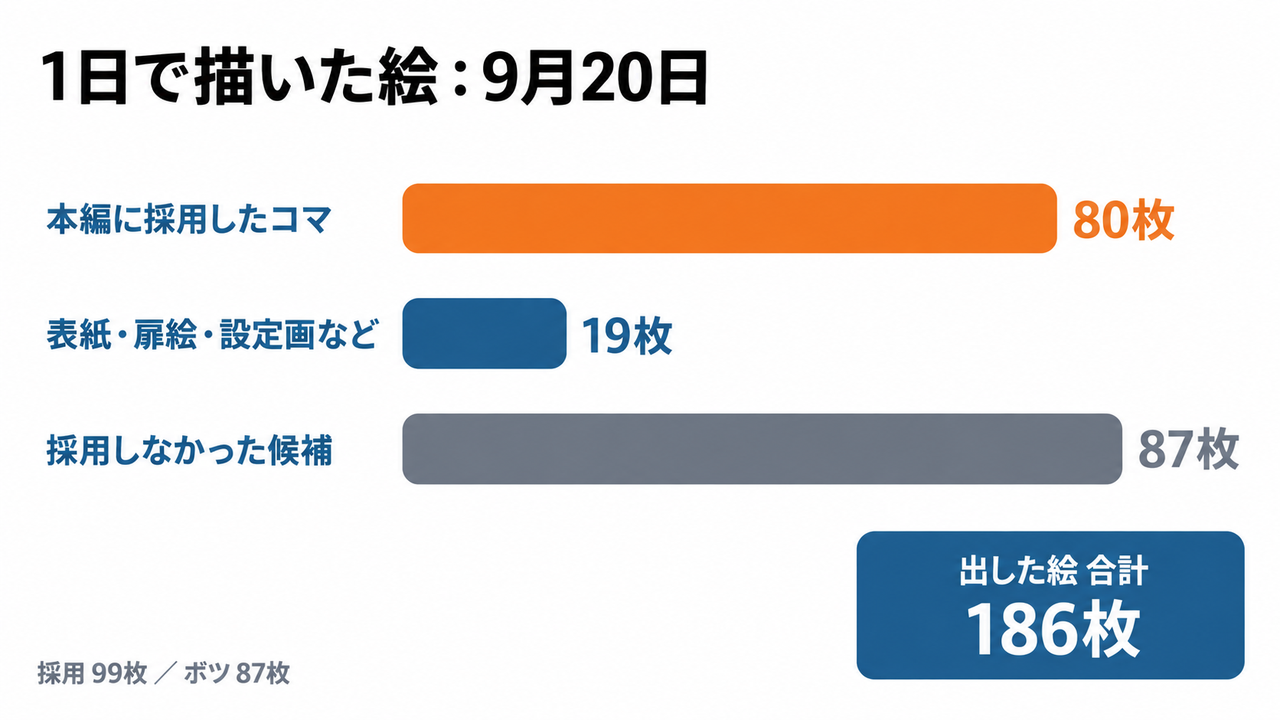
出した絵が186枚。そのうち本編のコマとして採用したのが80枚、表紙や扉絵、キャラクターの設定画が19枚。残りの87枚は、描いたけれど使わなかった候補です。採用率でいうと53%。半分近くは捨てています。
捨てた分を無駄だと思わなくなったのが、自分でも意外でした。同じコマを2〜3枚出させて、いちばん良いものを選ぶ。選ばれなかった絵は 作画/_候補/ に残るので、あとから気が変わったら戻せます。
作業していた時間帯を見ると、昼の12時台から夜の21時台まで、まとまって手が動いていました。1日で、単行本1冊の半分くらいの枚数が出ていることになります。3年前の僕に言っても信じないと思います。
描いたあと、読むところまで作らないと終わらなかった
もうひとつ、作って分かったことがあります。描き上がっても、読める場所が無いと誰にも届きません。
最初はPDFで渡していました。でも、スマホで開くと文字が小さすぎて読めない。
なので、Webで読む画面も作りました。GitHub Pages に置いた、ただの静的なサイトです。ここもGitHubの無料の範囲に収まっています(GitHubがどこまで無料で使えるかは、以前ここに書きました)。
読みやすさのために直したのは、こんなところです。
- ページを1枚ずつめくるのをやめて、縦につなげてスクロールで読む形にした。11回クリックしていたのが、指を動かすだけになりました
- 1ページの表示を576×814から960×1397に広げた。セリフの文字が、だいたい1.7倍になりました
- 上下のバーを自動で隠す。読んでいる間、画面に出ているのは絵だけです
- スマホはフリックでめくれるようにした
漫画そのものより、この読む画面の調整に時間をかけています。
この作品は、こちらで読めます
行政バグります! ~梨ヶ坂市役所・特務トレンド係~
https://tsubasagit.github.io/gyosei-bug-reader/
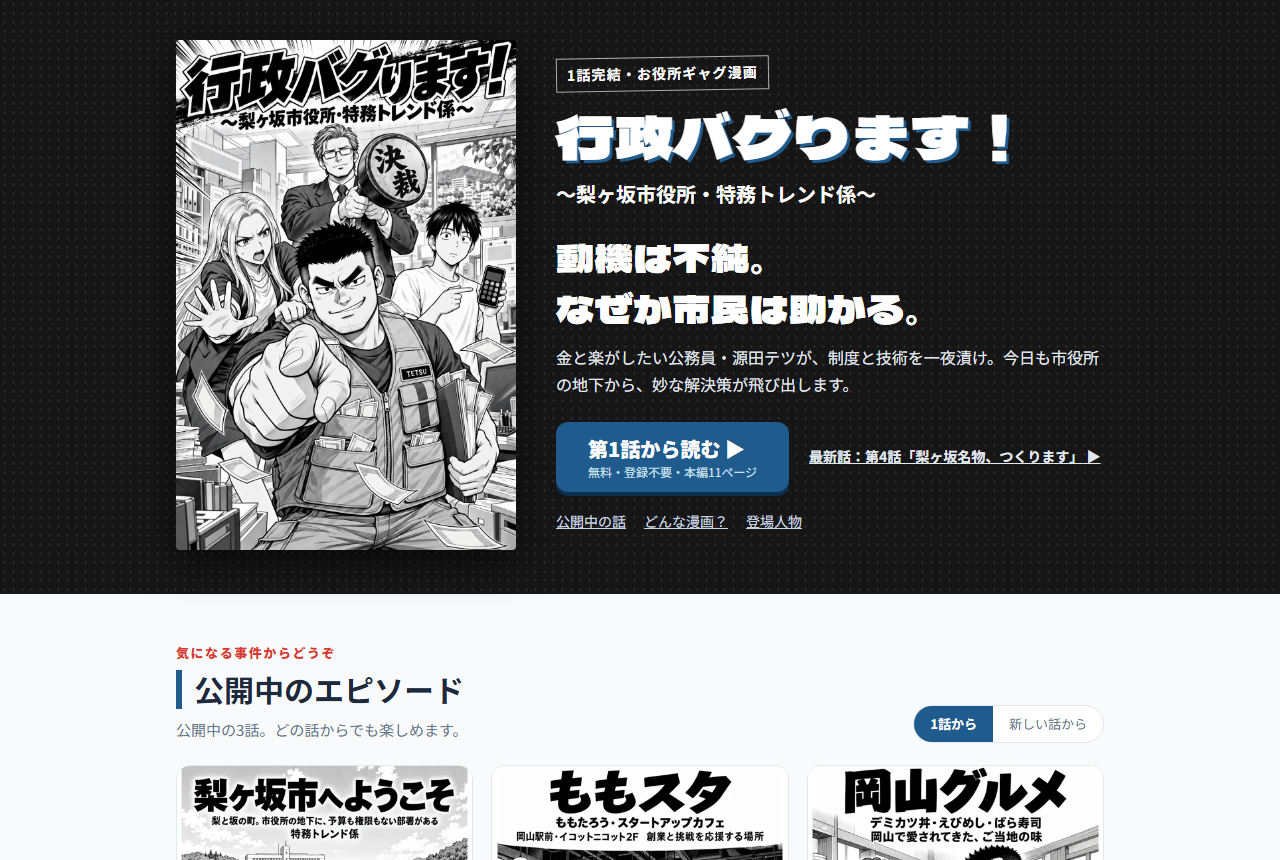
1話完結です。予算も権限もない部署に押し込められた公務員が、制度の隙間を突いて毎回もうけようとして、だいたい怒られます。
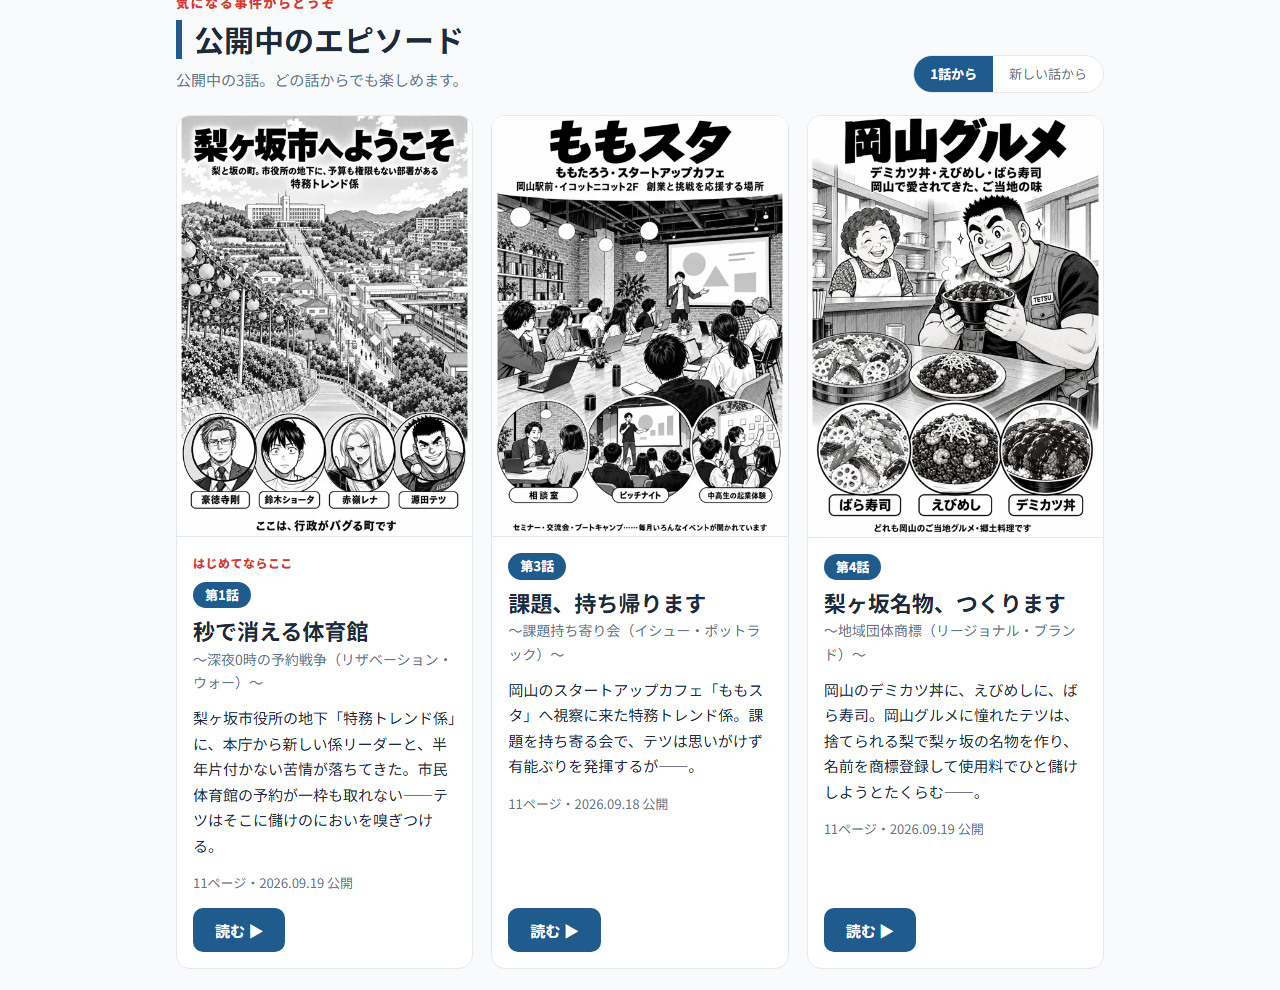
サイトを開くと、公開中の話が一覧で並びます。 各話に扉絵とあらすじ、ページ数と公開日が出るので、気になった事件から読めます。並び順は「1話から」と「新しい話から」を切り替えられて、選んだ順番はそのブラウザに覚えさせています。
この作品は、岡山の「ももスタ」2026夏でつくりました。地域のプロジェクトに参加しながら、その場で作った1話が、いまサイトに並んでいます。
英語版も、絵を描き直さずに出せた
公開したあとで、英語版も作りました。サイトのURLの後ろに ?lang=en を付けると、英語で読めます。英語のタイトルは「City Hall Bug!」にしました。
https://tsubasagit.github.io/gyosei-bug-reader/?lang=en
すぐにできたのは、セリフを全部データで持っていたからです。name-maker では、どのコマのどの吹き出しで誰が何を言うかを、先にファイルに書いてから作画します。なので英訳は、そのデータを1行ずつ訳すだけで済みました。
あとは、絵の中の吹き出しの日本語を白で消して、英語を書き入れる。ここまでをツールにしました。絵は1枚も描き直していません。
- 第1話・第3話・第4話の本編を英語にした。セリフとナレーションで、合わせて210行です
- 「ドドド」みたいな描き文字や、看板・書類に描き込まれた文字は日本語のまま残した
- 制度が絡むセリフには、英語のひとこと解説も付けた(労働基準法の深夜労働、商標の先願主義など)
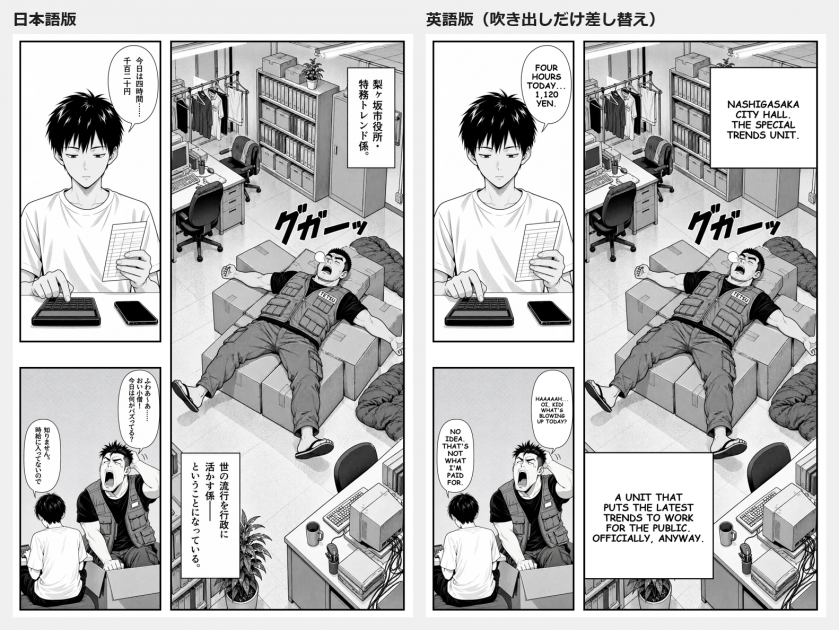
いちばん手がかかったのは、どの吹き出しにどのセリフを入れるかの割り当てでした。絵はネームの位置どおりに吹き出しを描いてくれないことがあって、自動で当てると外れるんですね。ここだけは、吹き出しの候補に番号を振った画像を見て、表で指定しています。
日本語で作って、あとから「この話を英語にして」と言えば英語版が出る。海外向けの資料や、多言語の社内教材でも、たぶん同じ形が使えます。
同じ作り方は、漫画以外にも応用可能
name-maker は漫画のために作りましたが、中でやっていることは漫画に限らないと思っていて。
続きの記憶をAIの中ではなくフォルダに置く。画面の設計は人間が型として持って、AIには中身だけ頼む。ぶれるものは文章ではなく参照画像で押さえる。そして、数えられる品質は目で見ずに数える。
このあたりは、AIに何かを量産させるときに、だいたいそのまま使えます。
社内マニュアル、研修教材、提案書のひな型。「1つなら作れるのに、100個は作れない」で止まっている仕事があれば、たぶん同じ形になります。
株式会社AppTalentHubでは、こうした「AIに任せる部分と、人が握る部分」の線引きから一緒に設計しています。ツールを納品して終わりではなく、続けられる作り方にするところまでが仕事だと思っています。
▼関連記事
「Claude Codeは遅い」を確かめる——ログで分けて、CodexとGrokbotと同じ課題で5回ずつ比べました
ネイティブアプリのビルドを節約する—テスト用はAPKを手元で作る